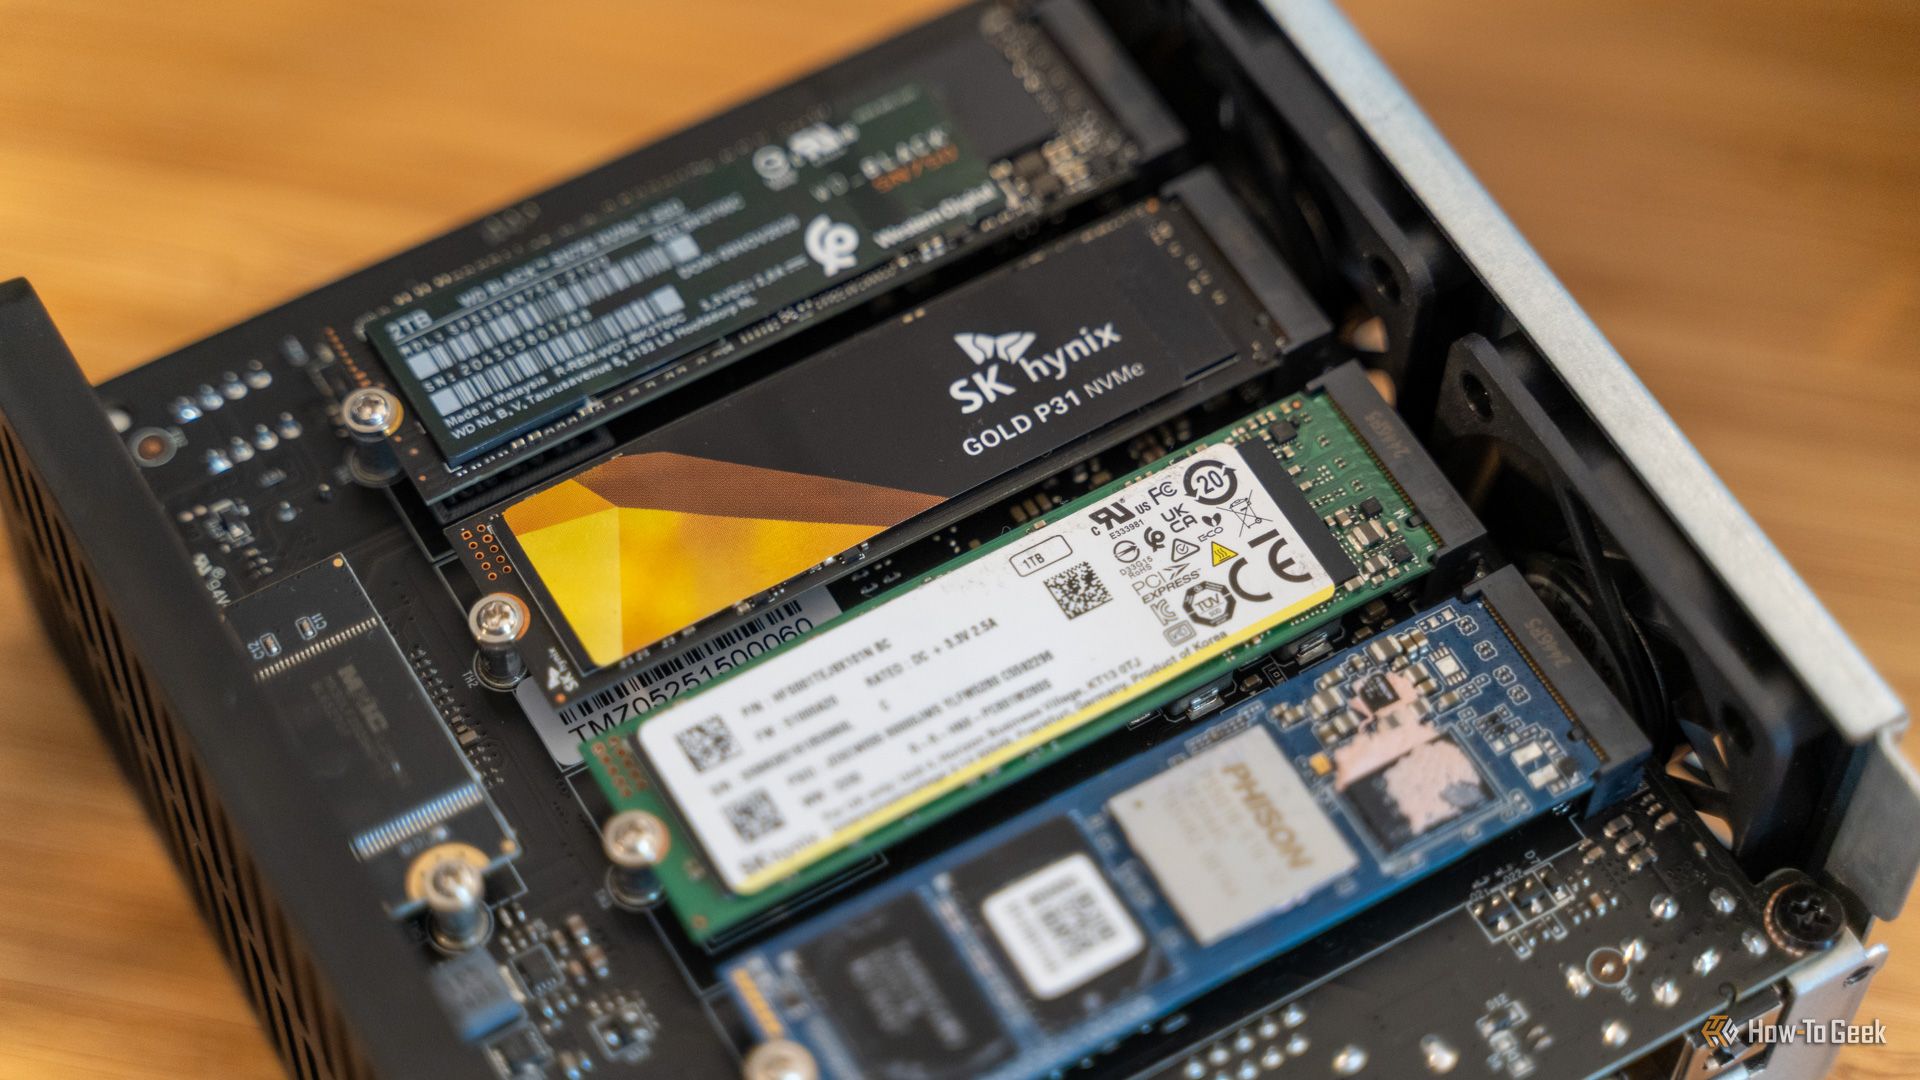
코드마스터입니다. 핵심부터 짚겠습니다. 많은 사용자가 SSD를 구매할 때 TBW(Total Bytes Written), 즉 '얼마나 많이 쓸 수 있는가'라는 수치에 집착합니다. 하지만 15년 동안 서버 아키텍렉처를 설계하고 다양한 스토리지 장애를 겪어온 엔지니어의 관점에서 볼 때, 쓰기 횟수 자체는 스토리지 사망의 주범이 아닙니다. 진짜 문제는 우리가 간과하고 있는 '시스템의 불안정성'에 있습니다.
과거 HDD(Hard Disk Drive) 시절, 우리는 물리적인 헤드의 충돌이나 배드 섹터를 걱정했습니다. SSD로 넘어오면서 그 공포는 '셀의 마모'로 옮겨갔죠. 하지만 현대의 SSD 컨트롤러는 매우 정교한 오픈소스 기반의 알고리즘과 복잡한 로직을 통해 셀의 수명을 관리합니다. 웨어 레벨링(Wear Leveling) 기술 덕분에 특정 셀에만 쓰기가 집중되는 것을 방지하며, 물리적 한계치에 도달하기 전에 이미 논리적인 교체 작업을 수행합니다. 그렇다면 우리는 무엇을 두려워해야 할까요?
SSD의 작동 원리와 수명에 대한 기술적 오해#
SSD의 핵심은 NAND Flash 메모리입니다. 전자를 가두는 절연층(Oxide Layer)에 전압을 가해 전자를 통과시키는 방식(Tunneling)을 사용하는데, 이 과정이 반복되면 절연층이 물리적으로 열화되는 것은 사실입니다. 이를 P/E Cycle(Program/Erase Cycle)이라고 부릅니다. 하지만 현대의 SSD 아키텍처는 이 한계를 극복하기 위해 매우 영리하게 설계되었습니다.
첫째, 웨어 레벨링(Wear Leveling)입니다. 컨트롤러는 데이터가 저장된 위치를 추적하며, 모든 셀이 균등하게 마모되도록 데이터를 재배치합니다. 둘째, 배드 블록 관리(Bad Block Management)입니다. 수명이 다한 셀을 논리적으로 격리하여 시스템 전체의 데이터 무인성을 유지합니다. 따라서 일반적인 사용자가 윈도우의 임시 파일을 삭제하거나 브라우저 캐시를 생성하는 정도의 쓰기 작업으로는 SSD의 물리적 수명을 다 채우는 것조차 불가능에 가깝습니다.
그렇다면 진짜 '스토리지 킬러'는 무엇일까요? 바로 '컨트롤러의 논리적 오류'와 '전력 공급의 불안정성'입니다.
진짜 위험 요소: 컨트롤러, 발열, 그리고 전력#
엔지니어링 관점에서 가장 치명적인 시나리오는 갑작스러운 전원 차단(Power Loss)입니다. SSD는 데이터를 쓰기 직전, 캐시 메모리에 데이터를 임시 저장합니다. 이때 전원이 차단되면 캐시에 있던 데이터와 실제 NAND에 기록된 데이터 사이의 불일치가 발생합니다. 특히 FTL(Flash Translation Layer)의 매핑 테이블이 깨지는 순간, SSD는 '읽기 전용' 모드로 잠기거나 아예 인식 불가능한 상태가 됩니다. 기업용 SSD에 고가의 커패시터(Capacitor)를 탑재하여 PLP(Power Loss Protection) 기능을 제공하는 이유가 바로 여기에 있습니다.
또한, 최근 NVMe 인터페이스의 대역폭이 비약적으로 상승하면서 '발열'이 새로운 변수로 등장했습니다. 고성능 SSD는 데이터 처리량이 늘어남에 따라 극심한 열을 발생시키며, 이는 스스로 성능을 낮추는 Throttling(스로틀링) 현상을 유발합니다. 지속적인 고온 노출은 컨트롤러의 논리적 오류를 가속화하고, 결국 데이터 무결성을 해치는 결과를 초래합니다.
여기에 저가형 SSD에서 흔히 보이는 DRAM-less 구조도 무시할 수 없습니다. DRAM이 없는 컨트롤러는 매핑 테이블을 NAND에 직접 저장해야 하므로, 데이터 위치를 찾는 과정에서 추가적인 쓰기 작업이 발생하고 이는 곧 성능 저하와 예상치 못한 오류의 씨앗이 됩니다. 여러분은 SSD를 선택할 때 단순히 용량과 가격만 보시나요, 아니면 DRAM 탑재 여부나 방열 솔루션을 고려하시나요?
실무자를 위한 스토리지 관리 가이드#
서버 운영자나 하이엔드 유저라면 스토리지의 수명(TBW) 수치보다는 다음과 같은 환경적 요인을 관리하는 데 집중해야 합니다. 이는 CI/CD 파이프라인의 로그 저장소나 데이터베이스용 스토리지의 안정성을 확보하는 데 필수적입니다.
- 안정적인 전원 공급(PSU) 확보: 스토리지에 가해지는 전압 스파이크나 갑작스러운 차단은 컨트롤러 사망의 1순위 원인입니다. 정격 용량이 충분하고 전압 변동폭이 적은 고품질 파워 서플라이를 사용하십시오.
- 적극적인 쿨링 솔루션 적용: NVMe SSD 사용 시 반드시 방열판(Heatsink)을 장착하십시오. 온도가 70도를 넘어가는 상황이 지속되는 것은 스토리지 아키텍처에 독을 붓는 것과 같습니다.
- TRIM 기능 활성화 확인: 운영체제에서 TRIM 명령이 정상적으로 전달되고 있는지 확인하십시오. 이는 불필요한 데이터를 미리 정리하여 쓰기 효율을 높이고 컨트롤러의 부담을 줄여줍니다.
- 정기적인 백업 아키텍처 구축: 하드웨어는 언제든 죽을 수 있습니다. RAID 구성이나 클라우드 동기화를 통해 '스토리지의 죽음'이 '데이터의 손실'로 이어지지 않도록 설계하십시오.
필자의 한마디#
결론은 명확합니다. SSD의 쓰기 횟수(TBW) 숫자에 매몰되어 불필요한 최적화 설정을 하느라 에너지를 낭비하지 마십시오. 대신, 시스템의 전원 안정성과 온도 관리, 그리고 데이터 백업 전략이라는 본질적인 엔지니어링 과제에 집중하십시오. 스토리지의 수명은 셀의 마모가 아니라, 여러분의 관리 부주의에서 끝날 확률이 훨씬 높습니다.
실무 관점에서 결론은 명확합니다. 댓글로 여러분의 스토리지 관리 노하우나 경험을 남겨주세요. 코드마스터였습니다.
출처: "https://www.howtogeek.com/i-stopped-worrying-about-ssd-write-cycles-after-learning-what-actually-kills-them/"
Sponsored Advertisement

💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성