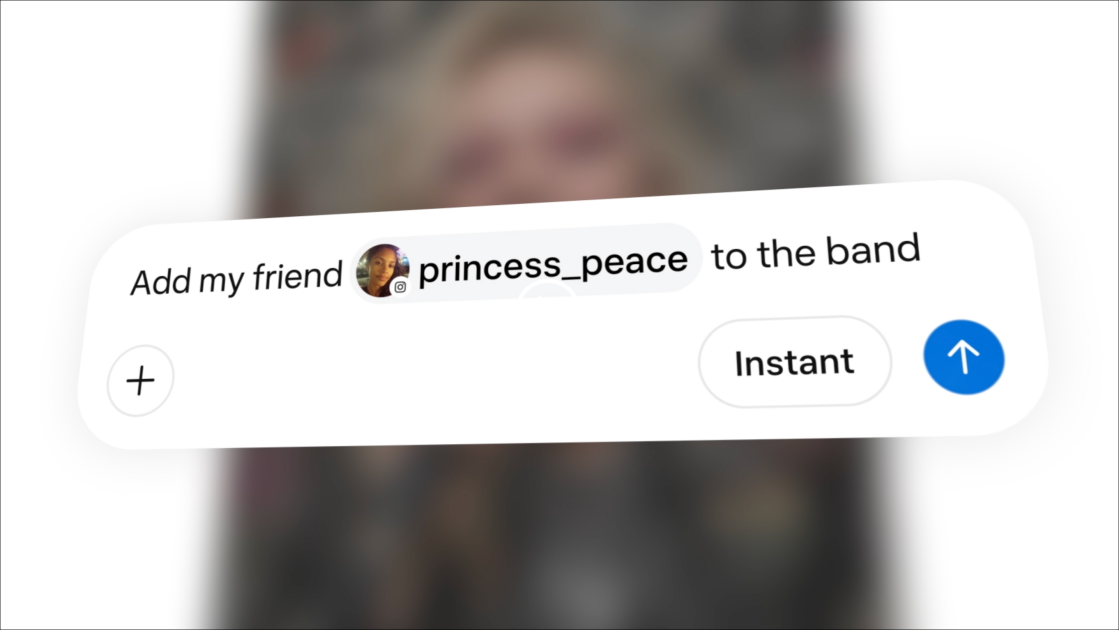
오프닝: 데이터 주권의 시대, Meta의 전략적 후퇴#
코드마스터입니다. 핵심부터 짚겠습니다. Meta가 최근 Instagram의 공개된 사진들을 활용해 AI 이미지를 생성할 수 있게 하려던 계획을 전격 철회했습니다. 이는 단순한 기능 업데이트의 취소가 아니라, 생성형 AI 시대를 맞이한 빅테크 기업들에게 던져진 강력한 경고장입니다.
최근 한국에서도 AI 학습용 데이터의 저작권과 개인정보 보호 이슈가 뜨거운 감자로 떠오르고 있습니다. 인공지능 모델의 성능을 높이기 위해 방대한 데이터가 필요하다는 것은 엔지니어라면 누구나 아는 사실이지만, 그 데이터의 '출처'와 '동의'가 빠진 아키텍처는 결국 사용자들의 거센 저항에 직면할 수밖에 없음을 이번 사건은 극명하게 보여줍니다.
핵심 내용: 데이터셋 확보를 위한 '지름길'이 막히다#
기술적인 관점에서 Meta의 의도는 명확했습니다. Diffusion Model과 같은 최신 생성형 AI 모델의 퀄리티를 결정짓는 핵심 요소는 바로 '학습 데이터셋(Training Dataset)'의 양과 질입니다. Meta는 Instagram이라는 거대한 플랫폼에 축적된, 이미 정제된 형태의 고해객성(High-resolution) 이미지 데이터를 활용해 자사 AI 모델의 성능을 비약적으로 끌어올리려 했습니다.
Meta의 초기 계획은 사용자가 Instagram에 공개로 설정해둔 사진들을 AI 이미지 생성의 소스로 활용하는 것이었습니다. 이는 별도의 외부 크롤링 없이도 자사 생태계 내에서 폐쇄형(Closed-loop) 데이터 파이프라인을 구축할 수 있는 매우 효율적인 전략이었습니다. 마치 CI/CD 파이프라인에서 검증된 소스 코드를 자동으로 빌드에 사용하는 것과 유사한, 데이터의 연속성을 확보하려는 시도였던 셈입니다.
하지만 문제는 '공개된 데이터(Public Data)'와 'AI 학습을 위한 활용' 사이의 간극에서 발생했습니다. 사용자들이 사진을 '공개'로 설정한 이유는 다른 사용자들과 소통하기 위함이지, 자신의 얼굴이나 일상이 AI 모델의 파라만큼 학습되어 새로운 이미지를 만들어내는 재료로 쓰이길 원해서가 아니었기 때문입니다. 기술적 효율성만을 추구하다가 데이터의 윤리적 거버넌스를 놓친 전형적인 사례라고 볼 수 있습니다.
심층 분석: 데이터 경제의 딜레마와 엔지니어링의 과제#
현재 AI 산업의 지형도를 살펴보면, OpenAI나 Google 같은 기업들은 웹 크롤링을 통해 방대한 데이터를 확보해 왔으나 끊임없는 저작권 소송에 휘말려 있습니다. Meta는 이들과 차별화하기 위해 자사 플랫폼 내의 '보유 데이터'를 활용해 보다 안전하고 독점적인 데이터 아키텍처를 구축하려 했던 것입니다. 만약 이 계획이 성공했다면, Meta는 독보적인 퀄리티를 가진 이미지 생성 모델을 보유하게 되었을 것입니다.
하지만 이번 사태는 데이터의 'Provenance(출처 및 이력)' 관리가 얼마나 중요한지를 재확인시켜 주었습니다. 아무리 오픈소스 라이브러리를 활용해 모델을 구축하더라도, 그 기초가 되는 데이터의 적법성이 확보되지 않는다면 전체 시스템의 신뢰도는 무너집니다. 이는 마치 보안 취약점이 발견된 오픈소스 패키지를 사용하는 것과 같습니다. 겉으로는 완벽한 서비스처럼 보여도, 근본적인 데이터 오염(Data Poisoning)이나 법적 리즘(Legal Risk)에 노출될 위험이 크기 때문입니다.
저는 이번 사건이 향후 AI 모델 학습 파이프라인에 'Privacy-preserving Machine Learning(개인정보 보호 기계 학습)' 기술의 도입을 가속화할 것이라고 분석합니다. Federated Learning(연합 학습)이나 Differential Privacy(차분 프라이버시)와 같은 기술적 대안이 단순한 연구실의 이론을 넘어, 기업의 실질적인 서비스 아키텍처에 필수적인 컴포넌트로 자리 잡게 될 것입니다.
여기서 여러분께 질문을 던지고 싶습니다. 만약 여러분의 SNS 사진이 AI 학습에 사용된다는 공지에 '동의' 버튼을 누르라고 한다면, 여러분은 서비스 이용을 위해 기꺼이 클릭하시겠습니까? 아니면 데이터 주권을 위해 서비스를 이탈하시겠습니까?
실용 가이드: 사용자를 위한 데이터 보안 체크리스트#
사용자로서 자신의 디지털 자산을 보호하기 위해 지금 바로 실행할 수 있는 몇 가지 체크리스트를 제안합니다.
- 계정 공개 범위 재점검: Instagram, Facebook 등 주요 SNS의 계정 설정에서 '공개'와 '비공개' 범위를 다시 한번 확인하십시오. AI 학습의 타겟이 되는 것은 기본적으로 'Public' 데이터입니다.
- 데이터 활용 옵션(Opt-out) 확인: Meta를 비롯한 글로벌 빅테크들은 사용자 반발에 따라 '데이터 활용 거부' 옵션을 제공하기 시작했습니다. 설정 메뉴 내 'AI 학습 활용 동의' 관련 항목이 있는지 반드시 확인하고, 원치 않는다면 거부(Opt-out) 설정을 활성화하십시오.
- 플랫폼 약관 모니터링: 서비스 약관(Terms of Service) 업데이트는 매우 중요합니다. 특히 '데이터 활용 범위'나 '콘텐츠의 2차 저작물 활용'에 관한 조항이 변경될 때 주의 깊게 살펴보아야 합니다.
필자의 한마디#
실무 관점에서 결론은 명확합니다. 기술적 혁신은 반드시 사회적 합의와 윤리적 가이드라인 위에서 진행되어야 합니다. 데이터의 양적 팽창에만 매몰된 아키텍처는 결국 지속 가능하지 않습니다. 앞으로의 AI 엔지니어링은 '어떻게 더 많은 데이터를 모을 것인가'가 아니라, '어떻게 신뢰할 수 있는 데이터를 안전하게 활용할 것인가'에 초점이 맞춰져야 합니다.
Meta의 이번 후퇴가 AI 산업에 있어 '윤리적 데이터 수집'이라는 새로운 표준을 만드는 계기가 되기를 바랍니다.
댓글로 여러분의 생각을 남겨주세요. 기술과 윤리의 균형, 어떻게 잡아야 할까요? 코드마스터였습니다.
출처: "https://www.pcmag.com/news/meta-axes-option-to-use-public-instagram-photos-to-generate-images"
Sponsored Advertisement


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성