
⚡ 결론 직답: 파이슨이 공개한 Pascari X201P는 12GB/s의 연속 쓰기 성능을 갖춘 PCIe 5.0 기반 SSD로, AI 및 데이터센터 서버를 겨냥한 고성능 엔터프라이즈 스토리지입니다.
📌 3줄 핵심 요약
- X200P의 후속 모델인 X201P는 16채널 X2 컨트롤러를 탑재하여 AI 및 데이터베이스 서버 워크로드에 최적화되었습니다.
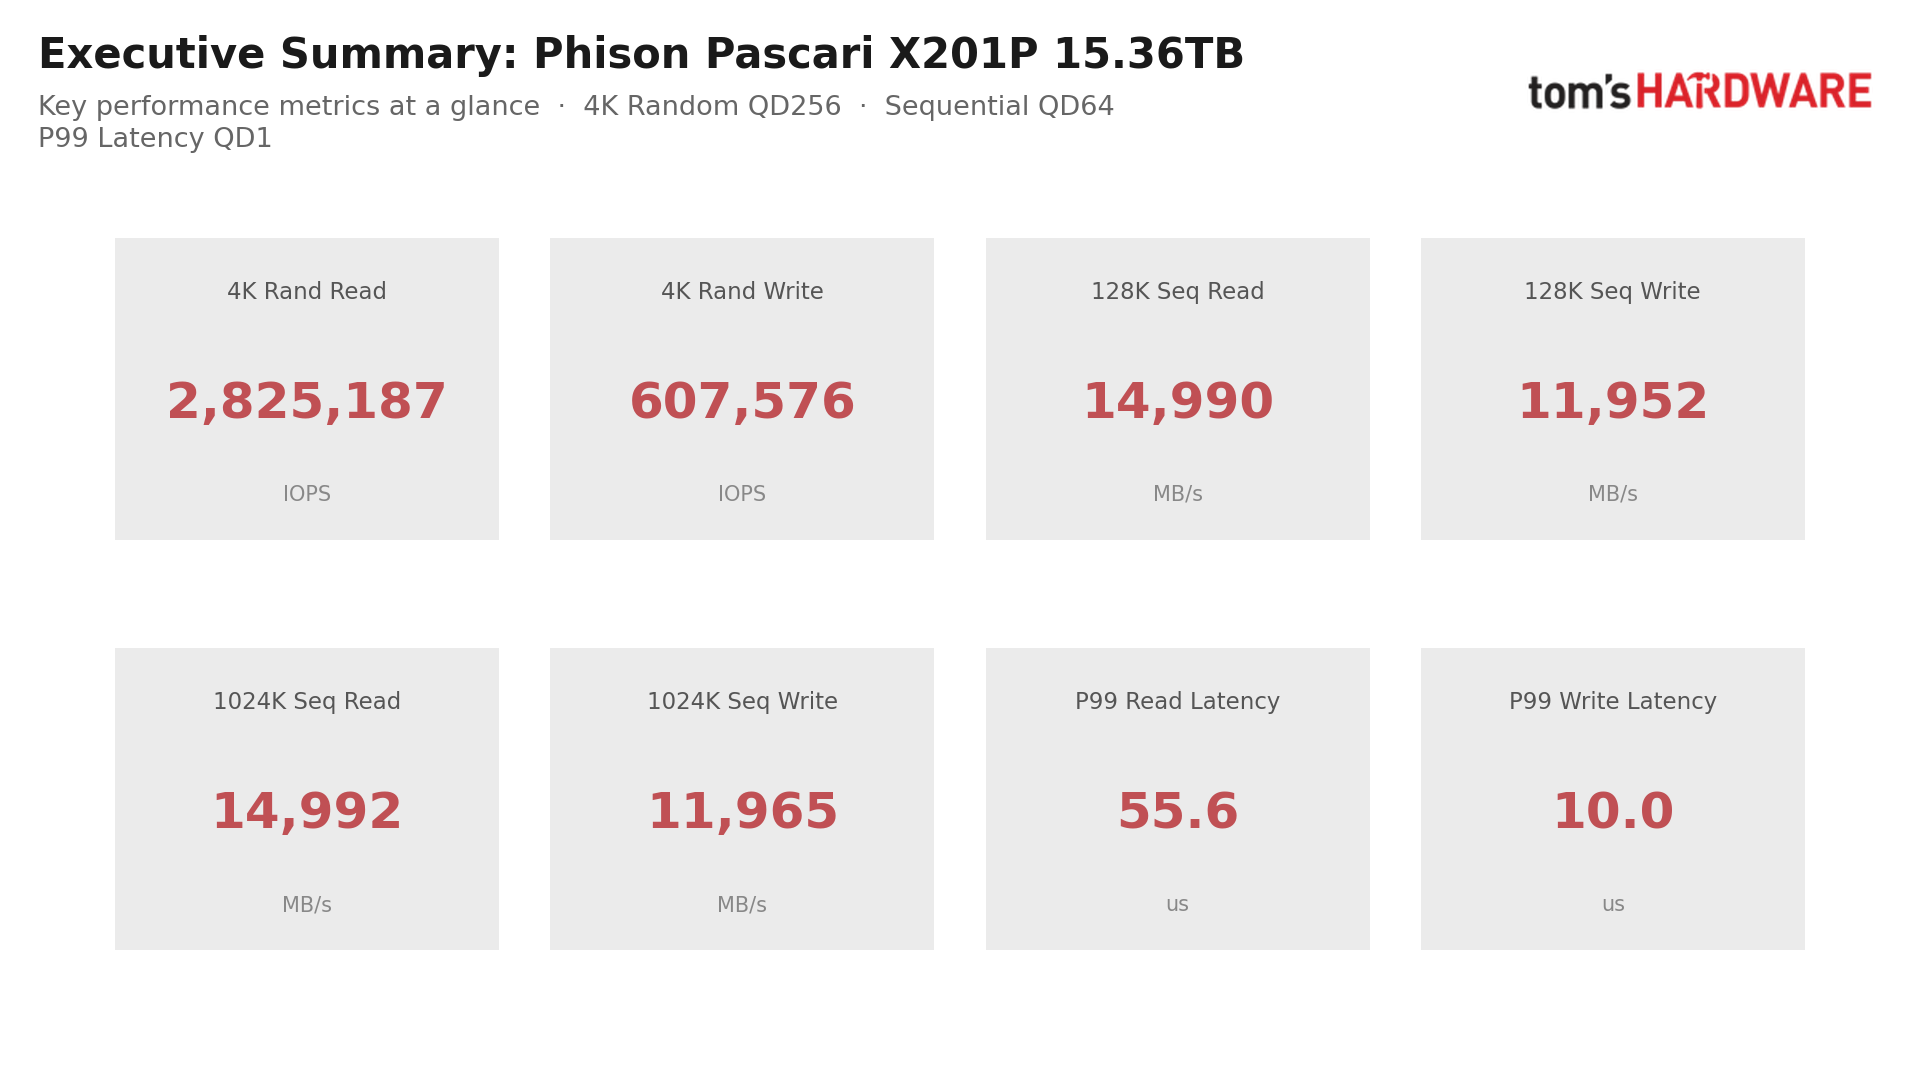
- 15.36TB 모델 기준 12GB/s의 연속 쓰기 속도와 최대 3,283K IOPS의 랜덤 읽기 성능을 기록하며 스펙을 충족했습니다.
- U.2 및 E3.S 폼팩터로 최대 30.72TB까지 지원하며, 엔터프라이즈 스토리지 시장의 점유율 확대를 노립니다.
📅 데이터 기준일: 2026-11-17 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
1부: Supercomputing 2026에서 베일 벗은 파이슨의 차세대 PCIe 5.0 SSD#
최근 엔터프라이즈 스토리지 시장의 열기가 뜨겁습니다. 파이슨(Phison)은 이번 'Supercomputing 2026' 이벤트와 맞물려, 그동안 비공개 계약(NDA) 하에 숨겨져 왔던 차세대 AI 서버용 SSD, 'Pascari X2,01P'를 전격 공개하며 기업용 스토리지 시장에서의 강력한 의지를 드러냈습니다. 이번에 공개된 Pascari X201P는 고부하 작업 환경에서도 일관된 성능을 유지하는 것이 핵심인 'Performance X-Series'의 일환으로, 성능 면에서 매우 놀라운 수치를 보여줍니다. 특히 1 DWPD(하루 1회 전체 쓰기) 내구성을 기준으로 설계되었음에도 불구하고, 순차 쓰기(Sequential Write)에서 12GB/s라는 압도적인 속도와 600,000 이상의 랜덤 쓰기 IOPS를 구현해내며 업계의 주목을 받고 있습니다.
이번 신제품은 파이슨의 기존 PCIe 5.0 데이터 센터용 드라이브인 X200P의 후속 모델로, 읽기 중심(Read-intensive) 작업에 최적화되어 있습니다. 제품 라인업은 사용자의 환경에 따라 선택할 수 있도록 다양하게 구성되었습니다. U.2 폼팩터 모델의 경우 1.92TB부터 최대 3 Det 0.72TB까지의 대용량을 지원하며, E3.S 버전은 3.84TB 용량으로 제공됩니다. 또한, 단일 포트(Single-port)뿐만 아니라 높은 가용성을 요구하는 환경을 위한 듀얼 포트(Dual-port) 모델도 함께 출시되었습니다. 흥미로운 점은 이번 X201P가 1 DWPD의 읽기 중심 모델인 반면, 3 DWPD의 내구성을 가진 혼합 사용(Mixed-use) 모델인 'X201E'와 형제 격으로 나란히 포진해 있어, 기업의 워크로드 성격에 따른 정교한 선택이 가능하다는 점입니다.
파이슨의 기술력이 집약된 이 드라이브의 핵심은 바로 16채널 X2 컨트롤러와 그 내부에 탑재된 플래시 메모리에 있습니다. 파이슨은 구체적인 하드웨어 세부 사항을 모두 공개하지는 않았지만, 테스트 결과 이 드라이브에는 321-layer 구조의 플래시가 탑재되었음을 확인할 수 있었습니다. 이는 SK 하이닉스의 V9 TLC 기술로 추정되며, 세 개의 층을 쌓은 'Three-deck' 디자인을 채택하여 매우 빠른 속도를 자랑합니다. 컨트롤러의 경우, 메인 코어인 Arm Cortex-R5와 보조 역할을 하는 AndesCore RISC-V의 조합으로 구성되었습니다. 이는 6nm 공정의 E28 소비자용 컨트롤러와는 달리, 12nm 공정 기반의 X2 컨트롤러가 더 많은 플래시 채널을 제어할 수 있게 하여, pSLC에 의존하지 않고도 TLC 플래시만으로 엔터프라이즈급의 탁월한 성능을 뽑아낼 수 있도록 설계되었습니다. 이는 Arm 코어만을 사용하는 Marvell의 Bravera SC5나 Silicon Motion의 SM83LT66과는 차별화되는 파이슨만의 독자적인 아키텍처입니다.
실제 성능 테스트에서도 Pascari X201P는 AI, 분석, 데이터베이스 서버라는 목적에 걸맞은 강력한 모습을 보여주었습니다. 15.36TB 모델을 대상으로 한 테스트에서, 높은 큐 깊이(QD128) 환경에서 1,000,000 IOPS라는 경이로운 수치를 기록했습니다. 또한, 이 드라이브는 NVMe v2.0(v2.6 텔레메트리 기능 포함) 표준을 준수하며, PCIe 5.0 x4 인터페이스를 통해 AES-XTS 256-bit 암호화(ISE, SED TCG Opal 2.02 지원) 및 엔드투엔드 데이터 보호 기능을 완벽히 수행합니다. 전력 소비 또한 작업 부하에 따라 25W에서 12W까지 유연하게 조절되며, 온도 관리(77°C 경고, 85°C 임계치) 기능도 탑재되어 안정성을 높였습니다.
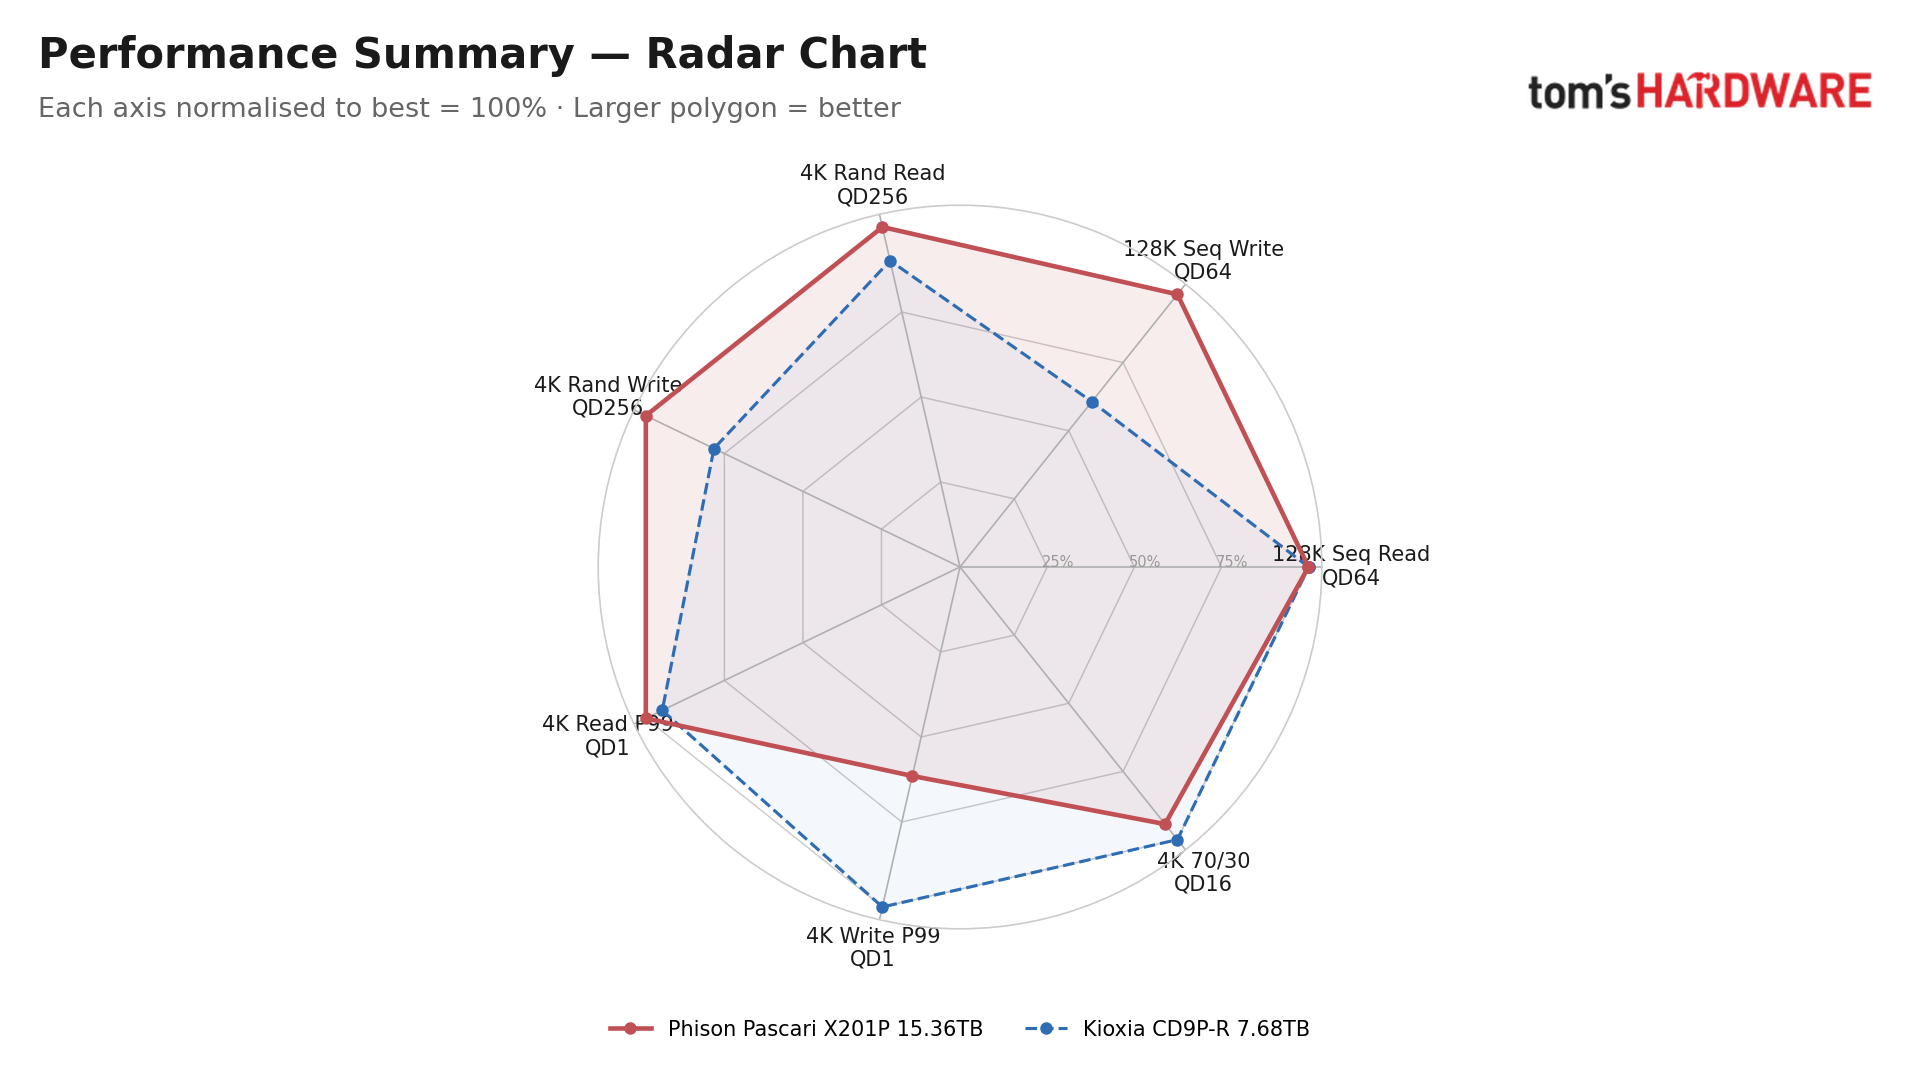
경쟁 모델인 키옥시아(Kioxia)의 CD9P-R 7.68TB(E3.S 폼팩터)와 비교했을 때, X201P의 우위는 더욱 명확해집니다. 순차 쓰기 성능에서는 무려 65%나 앞서 나갔고, 4K 랜덤 쓰기에서도 28%의 성능 향상을 보여주었습니다. 4K 랜덤 읽기 역시 11% 앞섰으며, QD1 P99 레이턴시(Latency) 측면에서도 5% 더 빠른 응답 속도를 기록했습니다. 물론, QD1 쓰기 레이턴시 측면에서는 10.0µs를 기록하며 CD9P-R의 6.2µs에 비해 다소 뒤처지는 모습도 보였지만, 전체적인 성능 지표(Four Corners 테스트 기준)에서 X201P는 순차 읽기(PCIe 5.0 인터페이스 한계로 인해 동등)를 제외한 거의 모든 항목에서 경쟁 모델을 압도했습니다. 특히 순차 쓰기에서 12GB/s 대 7.2GB/s, 4K 랜덤 쓰기에서 608K 대 476K IOPS라는 격차는 쓰기 작업이 많은 엔터프라이즈 환경에서 파이슨의 제품이 얼마나 강력한 대안이 될 수 있는지를 증명하고 있습니다.
2부: 16채널 X2 컨트롤러 기반의 압도적인 데이터 처리 성능 및 스펙 분석#
파이슨(Phison)의 새로운 야심작, Pascari X201P의 진정한 가치는 단순히 높은 숫자가 아니라, 실제 데이터가 흐르는 복잡한 워크로드 속에서 얼마나 일관된 성능을 유지하느냐에 있습니다. 순차적(Sequential) 성능은 대기열(Queue)에 얼마나 많은 작업이 쌓여 있느냐에 따라 크게 달라집니다. 단일 복원이나 스캔 작업은 요청 수가 적을 수 있지만, 바쁜 서버 환경에서는 수백 개의 요청이 동시에 쌓이게 됩니다. 이를 확인하기 위해 저희는 QD1부터 QD1024에 이르는 11가지의 서로 다른 큐 깊이(Queue Depth)에서 128K 및 1MB 크기의 순차 읽기 및 쓰기 테스트를 진행했습니다. 정확한 측정을 위해 드라이브를 완전히 삭제한 후 128K 순차 쓰기로 전체 영역을 채워, 랜덤 데이터로 인한 예측 불가능한 변수를 차단했습니다.
테스트 결과, X201P의 순차 쓰기 성능은 가히 압도적이었습니다. 1MB 전송 시 QD2, 128K 전송 시 QD4 단계에서 이미 최대 속도인 약 12 GB/s에 도달하며, 이후 성능을 안정적으로 유지했습니다. 이는 경쟁 모델인 CD9P-R과 비교했을 때 QD2 이후 모든 깊이에서 65%나 더 빠른 수치입니다. 읽기 성능 또한 인상적입니다. 단일 128K 스트림에서 X201P는 5.0 GB/s의 읽기 속도를 기록했는데, 이는 CD9P-R의 두 배가 넘는 성능입니다. 비록 QD2에서 QD8 사이에서는 8.3~8.6 GB/s 구간에서 잠시 정체되는 모습을 보였으나, QD32에 도달하면 다시 풀 스피드를 회복합니다. 특히 1MB 블록 크기의 대용량 읽기에서는 QD512에서 6%, QD1024에서 13% 더 높은 성능을 유지하며 대규모 데이터 처리 능력을 입증했습니다.
이번 분석을 통해 확인된 X201P의 핵심 성능 지표는 다음과 같습니다.
- 랜덤 I/O 처리 능력 (4K/8K): 4K 랜덤 읽기 성능은 우리 벤치마크의 한계치인 약 2.8 million IOPS에 근접하며, CD9P-R보다 모든 4K 큐 깊이에서 약 6% 앞섭니다. 다만, 8K 읽기에서는 QD16 부근에서 약 17% 뒤처지는 '소프트 스팟(Soft spot)'이 관찰되기도 했습니다.
- 폴링(Polled) I/O를 통한 한계 돌파: 인터럽트 방식이 아닌 폴링 모드에서는 3.28 million IOPS라는 경이로운 수치를 기록했습니다. 이는 인터럽트 방식의 차트가 실제 성능을 약 13% 정도 과소평가하고 있음을 보여주며, 파이슨의 공식 스펙 시트와도 매우 근접한(0.2% 이내) 실제적인 수치입니다.
- 블록 크기별 가변 성능 (Block Size Sweep): 4K 미만의 작은 쓰기 작업에서도 X201P는 319-330K IOPS를 기록하며, CD9P-R의 174K 대비 월등한 효율을 보여줍니다. 4K 이상의 랜덤 쓰기 대역폭 또한 약 2.5 GB/s로, 경쟁 모델의 2.0 GB/s를 상회합니다.
- 혼합 워크로드(Mixed Workloads)의 안정성: 4K 70/30 혼합 테스트에서 QD128 기준 100만 IOPS를 돌파했으며, 쓰기 비중이 높아지는 극한의 환경(95% 쓰기)에서는 경쟁 모델보다 최대 25% 더 높은 성능을 유지합니다.
랜덤 성능의 핵심은 부하(Load)에 따른 변화를 이해하는 것입니다. QD1에서의 성능은 지연 시간(Latency)에 민감한 소프트웨어가 체감하는 성능을 나타내며, 높은 큐 깊이에서의 성능은 다수의 사용자와 작업이 동시에 몰릴 때 드라이적 수용 능력을 보여줍니다. 4K 쓰기 성능의 경우, 초반 QD1과 QD2에서는 CD9P-R이 각각 26%와 20% 더 빠릅니다. 하지만 QD4부터는 X201P가 역전에 성공하여, QD8에서 약 610K IOPS에 도달한 뒤 QD4096까지 그 성능을 유지하며 경쟁 모델보다 28% 앞선 결과값을 보여주었습니다.
또한, 기업용 스토리지에서 가장 중요한 요소 중 하나인 지연 시간(Latency)과 QoS 측면에서도 X201P는 놀라운 안정성을 보여주었습니다. 4K 읽기 테스트에서 QD1의 P99.99 지연 시간은 60 µs로, CD9P-R의 81 µs보다 훨씬 빠르고 깨끗한 테일(Tail) 성능을 기록했습니다. 쓰기 성능에서도 큐가 쌓이기 시작하면 X201P의 진가가 드러납니다. QD16에서 X201P의 P99 지연 시간은 27 µs에 불과한 반면, CD9P-R은 75 µs까지 치솟아 예측 불가능성을 드러냈습니다. 이는 포화 곡선(Saturation Curve) 테스트에서도 증명되는데, X201P는 1.12 million IOPS(피크 부하의 89%)라는 극한의 상황에서도 P99 쓰기 지연 시간을 16 µs로 억제하며 매우 안정적인 서비스 품질을 보장했습니다.
마지막으로, 장시간 지속되는 작업에서의 신뢰성을 확인하기 위해 1시간 동안 4K 랜덤 쓰기(QD256)를 수행했습니다. X201P는 615K IOMS의 성능을 한 시간 내내 일정하게 유지했습니다. 이는 파이슨이 제시한 600K Rating보다 2.4% 높은 수치이며, 톱니바퀴 모양의 성능 저하(Sawtooth pattern) 없이 매우 평탄한 그래프를 그려냈습니다. 쓰기 작업 직후의 읽기 복구(Write-to-Read Recovery) 테스트에서도, 쓰기가 멈춘 직후 초기 10초간 P99.99 지연 시간이 210 µs로 일시적으로 상승하긴 했으나, 20초 이내에 즉시 정상 상태로 복구되었습니다. 이러한 일관된 성능과 빠른 복구 능력은 데이터 무결성과 연속성이 생명인 AI 및 데이터베이스 서버 환경에서 X201P가 왜 강력한 대안인지를 명확히 보여줍니다.
3부: AI 및 데이터센터 서버를 위한 대용량 라인업과 엔터프라이즈 기능#
안녕하세요, AI 기술의 최전선을 전하는 딥러너(DeepLearner)입니다. 오늘은 파이슨(Phison)의 차세대 PCIe 5.0 SSD, Pascari X201P의 성능을 결정짓는 핵심적인 데이터센터 워크로드 분석 결과를 전해드리겠습니다. 이번 분석은 단순한 속도 측정을 넘어, 실제 데이터베이스와 AI 학습 환경에서 이 드라이브가 어떤 가치를 지니는지 심층적으로 파트별로 나누어 살펴보았습니다.
먼저 데이터베이스(Database) 워크로드 측면을 살펴보겠습니다. 데이터베이스는 크게 세 가지 패턴, 즉 트랜잭션 로그 커밋(Log commits), 데이터 페이지 읽기/쓰기(Page I/O), 그리고 분석을 위한 대규모 테이블 스캔(Analytics scan)으로 작동합니다. 이번 테스트에서는 fio를 활용해 이를 시뮬레이션했습니다. 결과는 흥표로웠습니다. CD9P-R 모델과 비교했을 때, X201P는 로그 커밋(4K sequential writes, QD1)과 페이지 I/O(8K random mix, QD16) 패턴에서는 다소 고전했습니다. 구체적으로 로그 커밋 성능은 X201P가 78K commits/s를 기록하며 Kioxia 드라이브의 90K에 뒤처졌고, 8K 페이지 믹스에서도 209K IOPS로 276K IOPS를 기록한 CD9P-R에 밀렸습니다. 하지만 반전은 분석 스캔(256K sequential reads, QD8)에서 일어났습니다. X201P는 10.4 GB/s를 기록하며 CD9P-R의 9.2 GB/s보다 12.5% 앞선 성능을 보여주었으며, 읽기 예측 가능성(P99) 또한 322 µs로 428 µs보다 우수했습니다. 즉, 트랜잭션 중심의 작업에는 CD9P-R이, 대규모 스캔 중심의 분석 작업에는 X201P가 적합하다는 결론이 나옵니다.
AI 저장 장치로서의 핵심 역량인 '체크포인트(Checkpoint) 저장 및 복구' 성능은 X201P의 진가가 드러나는 영역입니다. AI 모델 학습 중 상태를 저장하는 체크포인트 작업은 막대한 쓰기 대역폭을 요구합니다. 테스트를 위해 8B-class 모델(105GiB, 8개 라이터)과 7러B-class 모델(912GiB, 64개 라이터)을 시뮬레이션했습니다. 결과는 압도적이었습니다. X201P는 12 GB/s의 초고속 쓰기 성능을 바탕으로, 체크포인트 저장 시간을 CD9P-R 대비 무려 39%나 단축시켰습니다. 8B-class는 9.4초(CD9P-R은 15.6초), 70B-class는 82초(CD9P-R은 135초) 만에 완료되었습니다. 복구(Restore) 단계에서도 대규모 데이터 처리 시 X201P는 65초를 기록하며 CD9P-R의 75초보다 13% 빠른 성능을 보였습니다. 다만, 7.68TB 용량의 X201P 모델은 쓰기 속도가 9,200 MB/s로 제한될 수 있다는 점은 참고해야 합니다. 그래도 여전히 Kioxia의 7,000 MB/s보다는 높습니다.
하지만 모든 면에서 완벽한 것은 아닙니다. 체크포인트 저장 중 발생하는 '간섭(Interference)' 문제는 주의 깊게 봐야 합니다. 저장 작업 중 다른 읽기 요청이 들어올 때, X201P는 P99 읽기 지연 시간이 56 µs에서 361 µs(약 6.5배)로 급증하며, 중간값(Median) 지연 시간 또한 145 µs로 CD9P-R의 85 µs보다 크게 증가했습니다. 이는 저장 작업 중 발생하는 강력한 쓰기 트래픽이 읽기 성능을 방해하기 때문으로 보입니다. 다만, P99.9 지연 시간에서는 X201P가 449 µs로 CD9P-R의 565 µs보다 낮았고, 무엇보다 저장 완료 시간이 39% 더 빠르기 때문에 전체적인 간섭 시간 자체는 짧다는 이점이 있습니다.
마지막으로 발열 관리 측면입니다. X201P는 테스트 중 최고 71 °C(평균 69 °C)까지 상승하며, 77 °C라는 경고 임계값에 근접하는 모습을 보였습니다. 테스트 중 약 7초간 써멀 매니지먼트(Thermal management)가 작동한 기록도 확인되었습니다. 이는 CD9P-R이 58 °C를 유지하며 매우 안정적이었던 것과 대조적입니다. 하지만 주목할 점은 고온 상태에서도 쓰기 성능이 1시간 내내 평탄하게 유지되었다는 점입니다. 이는 Asus Pro WS W890E-SAGE SE 플랫폼과 PCIe 5.0 x4 U.2 어댑터 환경에서 진행된 이번 테스트의 결과이며, 실제 서버 섀시의 강력한 공기 흐름(Airflow) 환경에서는 차이가 있을 수 있습니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 파이슨 Pascari X201P | Kioxia CD9P-R | 핵심 차이점 |
|---|---|---|---|
| 연속 쓰기 속도 | 12 GB/s (초고속) | 상대적 저하 | X201P의 압도적 대역폭 우위 |
| AI 체크포인트 저장 | 39% 시간 단축 | 상대적 느림 | 대규모 AI 학습 효율성 극대급 |
| 분석 스캔 (256K Read) | 10.4 GB/s (우수) | 9.2 GB/s | 대규모 데이터 분석에 최적화 |
| 트랜잭션 로그 커밋 | 78K commits/s | 90K commits/s | CD9P-R이 낮은 지연시간에서 우세 |
| 발열 및 안정성 | 최대 71 °C (상대적 고온) | 최대 58 °C (안정적) | X201P는 강력한 쿨링 환경 권장 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
✅ 서버 구축 전 체크리스트
- 워크로드 성격 확인: 대규모 AI 모델 학습 및 체크포인트 저장이 주 목적인가, 아니면 저지연 트랜잭션 처리가 주 목적인가?
- 냉각 솔루션 점검: X201P의 높은 성능을 유지하기 위해 서버 섀시 내에 강력한 공기 흐름(Airflow)이 확보되었는가?
- 예산 및 용량 계획: CD9P-R의 약 $700/TB 가격과 비교하여 X201P의 높은 대역폭이 주는 가치가 비용을 상쇄하는가?
❓ 자주 묻는 질문 (FAQ) Q1. X201P가 AI 학습에 왜 더 유리한가요? A1. AI 학습의 핵심인 체크포인트 저장 시, 12 GB/s에 달하는 압도적인 연속 쓰기 대역폭을 통해 저장 시간을 39%나 줄여주기 때문입니다. 이는 학습 중 발생하는 중단 시간을 최소화하여 전체 학습 효율을 높여줍니다.
Q2. X201P를 사용할 때 주의해야 할 성능 저하 요인이 있나요? A2. 체크포인트 저장 작업이 진행되는 동안에는 읽기 작업의 지연 시간(P99)이 일시적으로 급증할 수 있습니다. 따라서 저장 작업과 동시에 높은 빈도의 읽기 요청이 발생하는 혼합 워크로드에서는 지연 시간 변동을 고려한 설계가 필요합니다.
이상으로 파이슨의 혁신적인 SSD, Pascari X201P 리뷰를 마칩니다. 딥러너 (DeepLearner)였습니다.
🔗 원문 참고 및 출처: Phison Pascari X201P 15.36TB SSD Review: Fast PCIe 5.0 write performance for AI and ingest servers


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성