
⚡ 결론 직답: AMD는 SC26에서 엔비디아의 FP64 에뮬레이션이 HPC 워크로드의 10% 미만에만 적합하다고 비판하며, 네이티브 FP64와 432GB HBM4를 탑재한 Instinct MI430X의 우수성을 강조했습니다.
📌 3줄 핵심 요약
- AMD는 엔비디아의 Ozaki 에뮬레이션이 dense GEMM(HPC 워크로드의 10% 미만)에만 유효하며, MI430X는 네이티브 FP64를 지원함
- 엔비디아 방식은 메모리 사용량을 최대 3배까지 늘릴 수 있으나, MI430X는 432GB HBM4를 통해 효율적인 컴퓨팅 노드 운영을 가능케 함
- MI430X는 고성능 과학 계산뿐 아니라 AI 추론 플랫폼으로도 활용 가능하며, 전력 및 데이터 센터 공간 비용 절감을 지원함
📅 데이터 기준일: 2026-11-17 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러이 (DeepLearner)입니다.
SC26의 격돌: AMD, 엔비디아의 FP64 에뮬레이션 방식 정면 비판#
이번 주 미국 시카고에서 막을 올린 'Supercomputing 2026(SC26)' 현장은 그 어느 때보다 뜨거운 기술 경쟁의 열기로 가득합니다. 특히 이번 행사에서는 AMD가 엔비디아(Nvidia)의 데이터 센터용 GPU 제품군이 가진 기술적 공백을 정조준하며 간접적인 비판을 가하고 있어 업계의 이목이 쏠리고 있습니다. AMD가 문제 삼고 있는 핵심은 바로 엔비디아 제품군에서 찾아보기 힘든 '네이튜브 FP64(64비트 배정밀도 부동 소점점)' 데이터 타입 지원의 부재입니다. FP64 연산은 고성능 과학 연산(HPC)과 정밀한 시뮬레이션 분야의 근간을 이루는 기술로, 이번 SC26의 핵심 주제이기도 합니다. AMD는 국가 연구소(national laboratories)나 슈퍼컴퓨팅 센터와 같이 여전히 강력한 네이티브 FP64 성능을 필요로 하는 고객들을 위해, 자사의 최신 가속기인 'Instinct MI430X'가 가진 독보적인 가치를 전면에 내세우고 있습니다.
엔비디아의 이러한 기술적 변화에는 나름의 비즈니스적 전략이 깔려 있습니다. 지난 몇 년간 엔비디아는 데이터 센터용 GPU의 다이(die) 면적을 재할으로 재배치하는 결단을 내렸습니다. 즉, 전통적인 배정밀도 연산에 할당하던 자원을 현대 AI 추론(inference) 성능을 극대화할 수 있는 저정밀도 행렬 연산(lower-precision matrix math) 영역으로 옮긴 것입니다. 이는 매우 영리한 시장 대응이라 볼 수 있습니다. AI 컴퓨팅을 위한 전체 시장 규모(TAM)는 그야말로 폭발적으로 성장한 반면, 대규모 슈퍼컴퓨팅 인프라에서의 배정밀도(double-precision) 연산 수요는 상대적으로 정체된 상태이기 때문입니다. 엔비디아 입장에서는 수익성이 높은 AI 시장의 수요에 집중하는 것이 경제적으로 훨씬 타당한 선택이었을 것입니다.
하지만 엔비디아는 네이티브 FP64 지원이 부족해진 기술적 공백을 메우기 위해 'Ozaki schemes'와 같은 기법을 활용한 에뮬레이션(emulation) 방식을 도입했습니다. 이는 소프트웨어적인 트릭을 통해 FP64 연산을 흉내 내는 방식입니다. 그러나 AMD는 이러한 에뮬레이션 방식이 네이티브 배정밀도 처리 능력을 결코 대체할 수 없다고 강력하게 주장합니다. AMD는 이러한 한계를 극복하기 위해 MI430X와 같은 특화된 제품 개발을 지속해 왔음을 강조하며, 엔비디아의 방식이 가진 근본적인 결함을 조목조목 짚어내고 있습니다.
AMD가 제시하는 구체적인 근거는 매우 설득력이 있습니다. AMD의 분석에 따르면, Ozaki 에뮬레이션 방식은 연산 대상이 '밀집 행렬 곱셈(dense GEMM)'과 유사한 형태를 띤다는 전제 조건이 필요합니다. 하지만 AMD가 직접 수행한 애플리케인 프로파일링(application profiling) 결과, 실제 HPC 워크로드 중 밀집 GEMM 연산을 수행하는 비중은 "10% 미만"에 불과한 것으로 나타났습니다. 즉, 밀집 선형 대수(dense linear algebra) 작업에는 에뮬레이션이 적절한 대안이 될 수 있을지 몰라도, 그 외의 광범위한 영역에서는 한계가 명확하다는 것입니다.
특히 AMD는 다음과 같은 고도의 정밀도를 요구하는 다양한 워크로드에서는 반드시 강력한 FP64 벡터 성능이 뒷받침되어야 한다고 강조합니다. 여기에는 희소 반복 선형 대수(sparse iterative linear algebra), 스텐실(stencils), 유체 역학(hydrodynamics), 고차 유한 요소 분석(high-order finite element analysis), 몬테카를로(Monte Carlo), 입자 수송(particle transport), 그리고 고전적 분자 역학(classical molecular dynamics) 등이 포함됩니다. 이러한 복잡한 물리적 시뮬레이션에서는 아주 작은 오차도 결과에 치명적일 수 있기 때문에, 에뮬레이션이 아닌 네이티브 연산 능력이 필수적입니다.
더 나아가 AMD는 기술적인 디테일에서도 엔비디아의 방식을 압박하고 있습니다. 설령 어떤 워크로드가 GEMM 연산에 잘 매칭된다 하더라도, 최적의 성능을 내기 위해서는 행렬의 크기가 충분히 커야 한다는 제약이 따릅니다. 또한 행렬의 피연산자(operands) 크기가 하드웨어 구조에 최적화되어 설계되어야 하며, 만약 피연산자의 스케일링이 잘못될 경우 전체적인 성능 저하가 발생할 수 있습니다. 반면, AMD의 Instinct MI430X가 제공하는 FP64 벡터 연산 능력은 이러한 피연산자 크기 문제(operand sizing issues)에 민감하게 반응하지 않고 일관된 고성능을 보장한다는 점이 가장 큰 차별점입니다.
Ozaki 방식의 한계: 10% 미만의 적합성과 3배에 달하는 메모리 부담#
안녕하세요, 테크 에디터 딥러너(DeepLearner)입니다. 이번 SC26 현장에서 AMD가 던진 메시지는 단순한 성능 경쟁을 넘어, 엔비디아(Nvidia)가 채택한 기술적 우회로의 '비용 문제'를 정면으로 겨냥하고 있습니다. 엔비디아가 FP64(배정밀도) 연산 지원을 줄이는 대신 선택한 Ozaki 에뮬레이션(emulation) 방식이 실제 슈퍼컴퓨팅 환경에서 얼마나 치명적인 자원 낭비를 초래할 수 있는지, AMD는 구체적인 수치를 통해 경고하고 나섰습니다.
AMD의 분석에 따르면, Ozaki 방식은 모든 연산에 적용하기에는 매우 제한적입니다. 이 방식은 연산이 Dense GEMM(밀집 일반 행렬 곱셈) 형태를 띨 때만 효과적인데, 실제 HPC(고성능 컴퓨팅) 워크로드 중 이러한 형태를 차지하는 비중은 10% 미만에 불과하기 때문입니다. 문제는 이 외의 워크로드에서 발생하는 부작용입니다. 에뮬레이션을 사용할 경우 애플리케이션의 메모리 풋프린트(Memory footprint)가 최대 3배까지 급증할 수 있다는 점이 지적되었습니다.
이러한 메모리 부담은 단순히 소프트웨어의 문제를 넘어 하드웨어 인프라 전체의 연쇄적인(casc재적인) 비용 상승으로 이어집니다. 현대의 슈퍼컴퓨팅 환경에서 HBM(고대역폭 메모리) 용량은 GPU의 핵심 사양이며, 이는 곧 전체 시스템의 규모를 결정짓는 척도가 됩니다. 메모리 사용량이 늘어나면 이를 수용하기 위해 더 많은 GPU와 컴퓨팅 노드가 필요하게 되고, 결과적으로 데이터 센터의 바닥 면적(Floor area), 전력 소모량(Power), 그리고 냉각 시스템(Cooling)에 막대한 추가 부담을 주게 됩니다.
이와 관련하여 AMD가 제시한 핵심 기술적 차별점과 데이터는 다음과 같습니다.
- 메모리 효율성 및 인프라 비용: Ozaki 에뮬레이션 사용 시 메모리 요구량이 최대 3배까지 증가할 수 있으며, 이는 GPU 및 컴퓨팅 노드 수의 증가로 이어져 전력과 냉각 비용을 상승시킵니다.
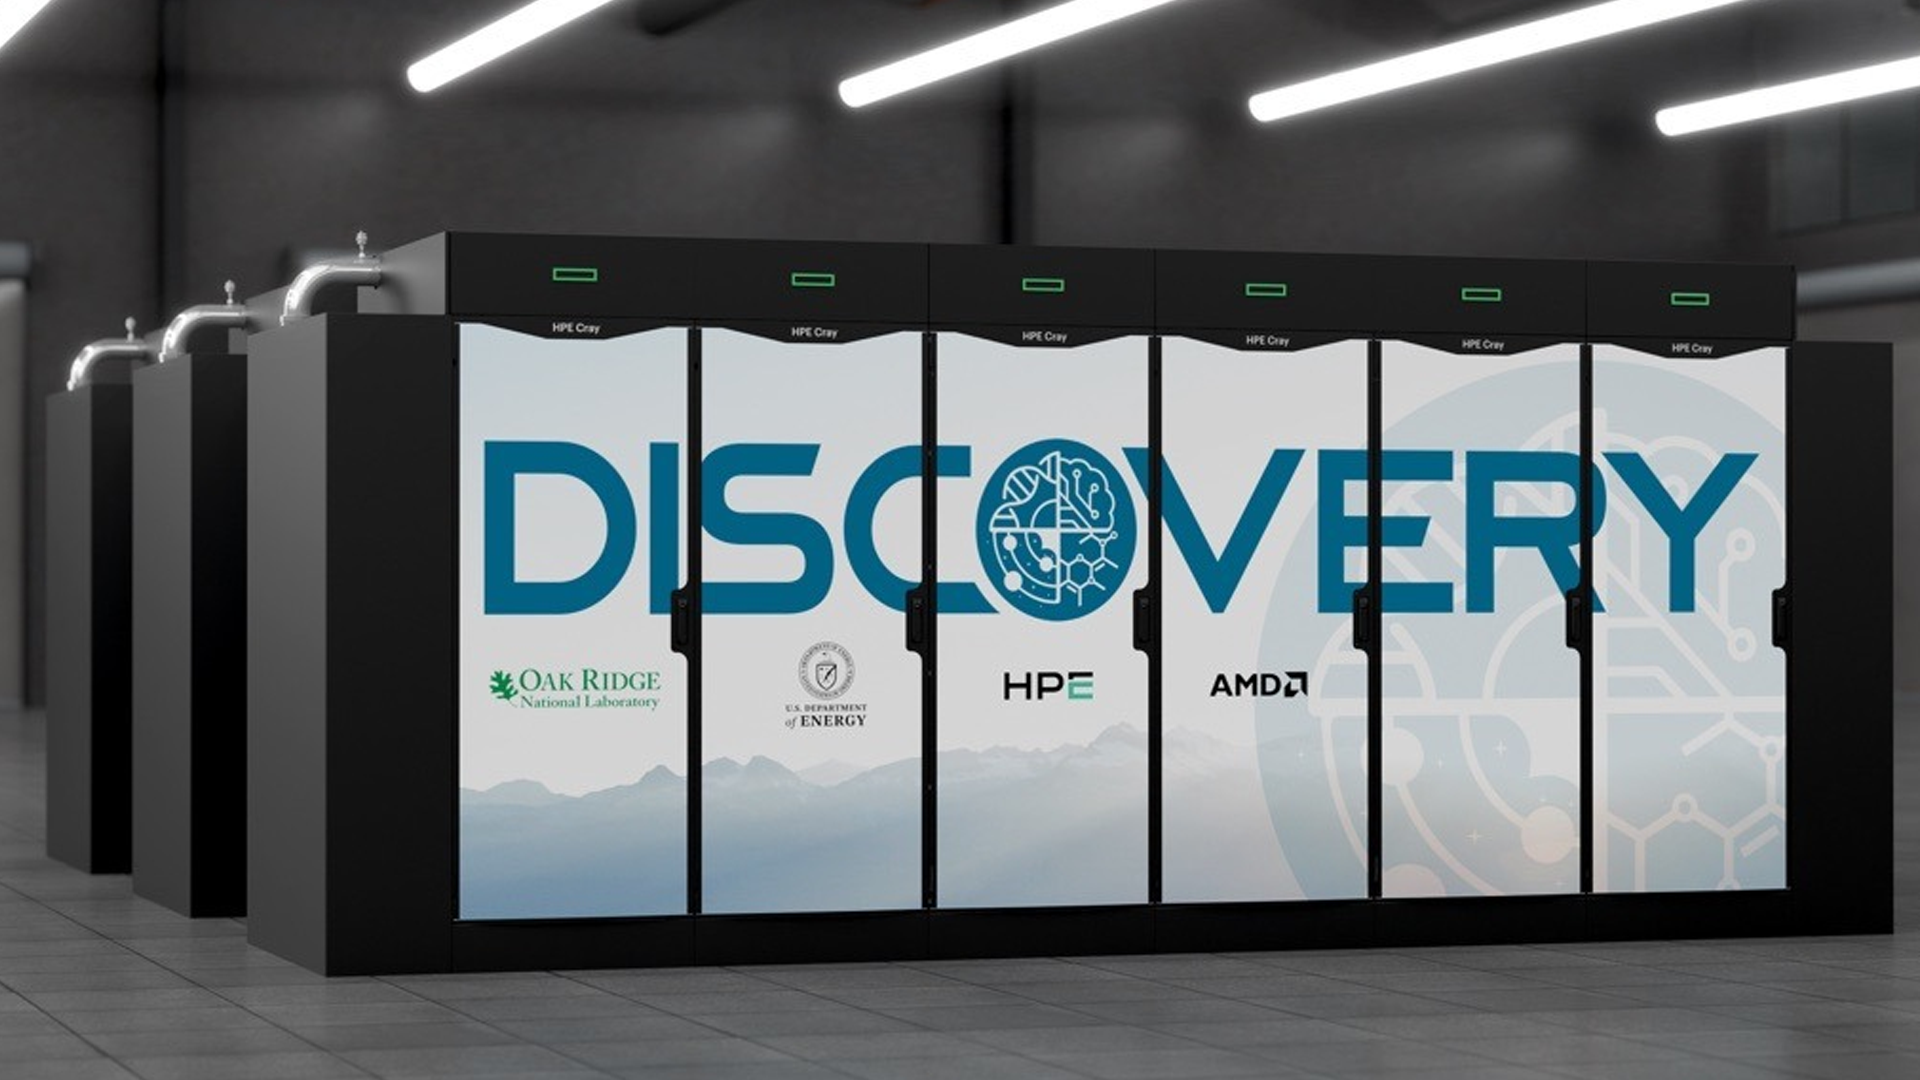
- MI430X의 HBM4 혁신: Oak Ridge National Laboratory의 Discovery 슈퍼컴퓨터에 탑재된 MI430X GPU는 노드당 무려 432GB의 HBM4 메모리를 제공하여, 더 적은 수의 GPU와 노드로도 효율적인 시스템 구축이 가능합니다.
- AI 추론 성능의 격차: MI430X는 추론을 위해 9.2 PFLOPS의 이론적 FP4 연산 성능을 제공하지만, 이는 CDNA 5 아키텍처 기반의 MI455X가 보여주는 40.3 PFLOPS라는 압도적인 수치와는 큰 차이를 보입니다.
- 스케일업(Scale-up) 도메인 규모: 6세대 EPYC 호스트 CPU와 Infinity Fabric으로 연결된 4개의 MI430X 구성은 대규모 확장성보다는 지연 시간(Latency)에 민감한 작업에 최적화되어 있으며, 이는 72개의 MI455X가 탑재된 Helios 랙 스케일 가속기의 거대한 도메인 규모와 대조를 이룹니다.
AMD는 이러한 메모리 용량의 우위를 바탕으로, MI430X가 단순한 HPC용을 넘어 연구 프로세스의 일부로 모델을 활용하는 AI 추론(AI inference) 플랫폼으로서도 강력한 가치를 지닌다고 강조합니다. 특히 432GB라는 압도적인 HBM4 용량은 네트워크 대역폭과 전력, 공간을 절약할 수 있는 핵심 요소로 작용합니다.
물론 AMD 역시 모든 영역에서 무적이라고 말하지는 않습니다. CDNA 5 아키텍처 패밀리에 속하는 MI455X 기반의 Helios 랙 스케일 가속기와 비교했을 때, MI430X는 대규모 연산 확장성 측면에서 차이가 존재합니다. MI430X는 Infinity Fabric 인터커넥트를 통해 4개의 GPU를 연결하는 구조로, 이는 거대한 규모의 확장(Scale-up)보다는 낮은 지연 시간을 요구하는 작업에 더 적합하도록 설계되었습니다. 결과적으로 AMD의 전략은 '에뮬레이션이라는 불안정한 우회로 대신, 강력한 메모리 대역폭과 네이티브 FP64 지원을 통해 인프라 전체의 효율성을 극대화하겠다'는 것으로 풀이됩니다.
MI430X의 혁신: 43GB HBM4 기반의 고효율 HPC 및 AI 플랫폼#
반갑습니다. 테크 에디터 딥러너(DeepLearner)입니다. 오늘 전해드릴 소식은 AMD가 차세대 컴퓨팅 시장의 판도를 바꾸기 위해 준비한 강력한 무기, MI430X에 관한 심층 분석입니다.
모든 컴퓨팅 시스템의 사용자가 동일한 요구사항을 가진 것은 아닙니다. 특히 대규모 클라우드 인퍼런스(Inference) 서비스를 제공하는 기업과, 정밀한 과학적 계산을 수행하는 기관용 슈퍼컴퓨팅 시설은 그 목적부터가 근본적으로 다릅니다. 클라우드 인퍼런스 제공업체가 대규모 트래픽 처리에 집중한다면, 기관용 슈퍼컴퓨팅 시설은 단순한 추론을 넘어 고도의 정밀도를 요구하는 연산을 수행해야 하기 때문입니다.
이러한 맥락에서 AMD의 MI43급 플랫폼은 매우 전략적인 위치를 점하고 있습니다. 만약 여러분이 다루는 AI 모델이 4개의 MI430X GPU가 협업하여 만들어내는 1.72 TB의 압도적인 통합 HBM4 용량과 93.2 TB/s에 달하는 초고속 메모리 대역폭 범위 내에서 원활하게 작동한다면, 이 노드는 그야말로 최적의 환경이 됩니다. 특히 12.3 Tbps의 스케일업(Scale-up) 대역폭을 통해 노드 내에서 구현되는 강력한 연결성은, 정밀 연산(Double-precision) 워크로드와 AI 애플리케이션을 동시에 수행해야 하는 과학자와 엔지니어들에게 타협 없는 성능을 제공합니다.
이미 시장의 반응은 뜨겁습니다. MI430X는 이미 전 세계 주요 슈퍼컴퓨팅 프로젝트에서 '디자인 윈(Design Win)'을 확보하며 그 가치를 입증하고 있습니다. 미국의 오크리지 국립연구소(Oak Ridge National Laboratory)에서 가동될 예정인 차세대 'Discovery' 슈퍼컴퓨터, 프랑스의 'Alice Recoque' 설치 사례, 핀란드 CSC의 'LUMI-AI' 시스템, 그리고 독일의 'Herder' 시스템에 이르기까지, 이들 핵심적인 인프라들은 모두 MI430X가 제공하는 네이티브(Native) FP64 지원 기능을 채택할 예정입니다.
주목해야 할 점은 AMD의 기술적 자부심입니다. 엔비디아가 자사 제품군에서 FP64(배정밀도) 연산 능력을 점차 축소하거나 후퇴시키는 움직임을 보이는 것과 대조적으로, AMD는 네이티브 FP64 지원을 지속적으로 유지하고 있습니다. 비록 전 세계적으로 엔비디아와 AMD 기반의 AI 인퍼런스 설치 규모가 거대한 규모로 성장하며 기존의 기관용 슈퍼컴퓨터들을 압도할 수도 있겠지만, AMD의 엔지니어들에게 있어 이 정밀 연산 능력의 유지는 기술적 자부심의 원천입니다. 또한, AMD는 모든 시장에 동일한 제품을 공급하는 '원사이즈-핏-올(One-size-fits-all)' 방식 대신, 자사의 독보적인 세미 커스텀 실리콘 설계 능력과 칩렛(Chiplet) 경험을 활용하여 MI430X와 같은 제품을 특수 시장에 맞춰 최적화할 수 있는 유연성을 확보하고 있습니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 엔비디아(Nvidia)의 최근 트렌드 | AMD MI430X 플랫폼 | 핵심 차이점 |
|---|---|---|---|
| FP64 연산 지원 | 기능 축소 및 후퇴 경향 | 네이티브(Native) FP6한 지원 | 고정밀 과학 연산의 신뢰성 확보 |
| 제품 설계 전략 | 범용적(One-size-fits-all) 접근 | 세미 커스텀 및 칩렛 기반 설계 | 특정 목적(HPC)에 맞춘 유연한 최적화 |
| 메모리 및 대역폭 | 인퍼런스 중심의 구조 | 1.72 TB HBM4 / 93.2 TB/s 대역폭 | 대규모 모델과 정밀 연산의 병행 가능 |
| 주요 타겟 시장 | 클라우드 인퍼런스 서비스 | 기관용 슈퍼컴퓨팅 및 과학 연구 | 정밀도가 생명인 연구용 인프라 특화 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
🚀 워크로드 도입 전 체크리스트
- [ ] 연산 정밀도 확인: 수행하고자 하는 AI 모델이나 시뮬레이션이 네이티브 FP64(배정밀도) 연산을 필수적으로 요구하는가?
- [ ] 메모리 요구량 산정: 모델의 파라미터 규모가 4개 노드 결합 시 제공되는 1.72 TB의 HBM4 용량 내에서 효율적으로 운용 가능한가?
- [ ] 데이터 전송 병목 검토: 12.3 Tbps의 스케일업 대역폭을 활용하여 노드 간 데이터 이동 시 발생하는 지연 시간을 최소화할 수 있는 구조인가?
❓ 자주 묻는 질문 (FAQ)
Q1. 엔비디아 제품 대신 AMD MI430X를 선택해야 하는 결정적인 이유는 무엇인가요? A1. 가장 큰 차별점은 'FP64 네이티브 지원'에 있습니다. 엔비디아가 인퍼런스 성능에 집중하며 정밀 연산 기능을 축소하는 것과 달리, AMD는 과학적 계산에 필수적인 배정밀도 연산을 강력하게 지원합니다. 따라서 정밀한 수치 계산이 필요한 연구용 슈퍼컴퓨팅 환경에서는 MI4SSX와 같은 대안이 훨씬 유리합니다.
Q2. AMD의 칩렛(Chiplet) 기술이 MI430X의 성능에 어떤 도움을 주나요? A2. 칩렛 기술은 AMD가 가진 설계의 유연성을 극대화합니다. 모든 고객에게 동일한 칩을 파는 것이 아니라, 고객의 특수한 요구사항에 맞춰 실리콘 설계를 미세하게 조정(Semi-custom)할 수 있게 해줍니다. 이를 통해 MI430X는 특정 HPC 및 AI 워크로드에 최적화된 맞춤형 성능을 제공할 수 있습니다.
오늘 소식은 여기까지입니다. 차세대 컴퓨팅의 정밀한 미래를 설계하는 AMD의 행보를 계속해서 주목해 보겠습니다.
딥러너 (DeepLearner)였습니다.


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성