
⚡ 결론 직답: 엔비디아가 SC26에서 발표한 Vera CPU는 전용 소프트웨어 최적화를 통해 특정 워크로드에서 최대 39%의 성능 향상을 달성하며, 독자적인 Olympus 코어로 고성능 AI 연산을 지원합니다.
📌 3줄 핵심 요약
- 엔비디아는 Arm Neoverse V2 대신 독자 설계한 'Olympus' 마이크로아키텍처를 탑재하여 코어당 성능을 극대화했습니다.
- Vera CPU는 88개의 고성능 코어와 공간적 멀티스레딩 기술을 통해 총 176개의 스레드를 지원하며, 최적화 시 최대 39%의 성능 향상이 가능합니다.
- 범용 CPU를 지양하고 에이전틱 AI 및 데이터 처리 등 고대역폭과 저지연성이 필수적인 특수 워크로드에 최적화된 전략을 취하고 있습니다.
📅 데이터 기준일: 2026-11-17 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
최근 컴퓨팅 업계의 시선이 한곳으로 집중되고 있습니다. 바로 Supercomputing 2026(SC26)에서 공개된 엔비디아(Nvidia)의 차세대 CPU, 'Vera'에 대한 이야기입니다. 이번 발표는 단순히 새로운 하드웨어의 등장을 넘어, 엔비디를가 그리는 미래 데이터센터의 설계 철학을 엿볼 수 있는 중요한 변곡점이 될 것으로 보입니다.
1부: [SC26 발표] 소프트웨어 최적화로 성능 39% 끌어올리는 엔비디아 Vera CPU#
엔비디아가 SC26에서 야심 차게 선보인 'Vera' CPU는 매우 독특한 포지션을 가지고 있습니다. 이 프로세서는 단독으로 사용되는 데이터센터용 부품(standalone data-center part)으로서의 역할뿐만 아니라, 엔비디아의 차세대 서버 아키텍처인 'Vera Rubin NVL72' 서버의 호스트(host) 역할을 수행하도록 설계되었습니다. 기존의 'Grace' CPU와 비교했을 때, 코어당 실행 리소스(execution resources)를 대폭 늘림으로써 압도적인 성능 향상을 이뤄냈다는 점이 핵심입니다. 하지만 엔비디아는 이번 발표를 통해 솔직한 과제도 함께 던졌습니다. 현재의 기존 소프트웨어들이 Vera의 확장된 리소스를 온전히 활용하기 위해서는, 이 새로운 아키텍처에 맞춘 최적화 및 적응(adaptation) 과정이 반드시 필요하다는 점을 인정한 것입니다.
그렇다면 이 최적화의 가치는 얼마나 될까요? 엔비디아의 발표에 따르면, 아키텍처에 특화된 소프트웨어 최적화를 적용할 경우 특정 계산 집약적 워크로드(computationally intensive workloads)에서 Vera의 성능을 최대 39%까지 끌어올릴 수 있다고 합니다. 이는 매우 놀라운 수치입니다. 다만, 엔비디아는 Vera가 모든 종류의 범용 워크로드(general-purpose workloads)를 위해 설계된 것은 아니라고 선을 그었습니다. 대신, 압도적인 싱글 스레드 성능(single-thread performance)을 구현하는 데 초점을 맞추어 특정 고성능 컴퓨팅 영역에서의 우위를 점하겠다는 전략을 명확히 했습니다.
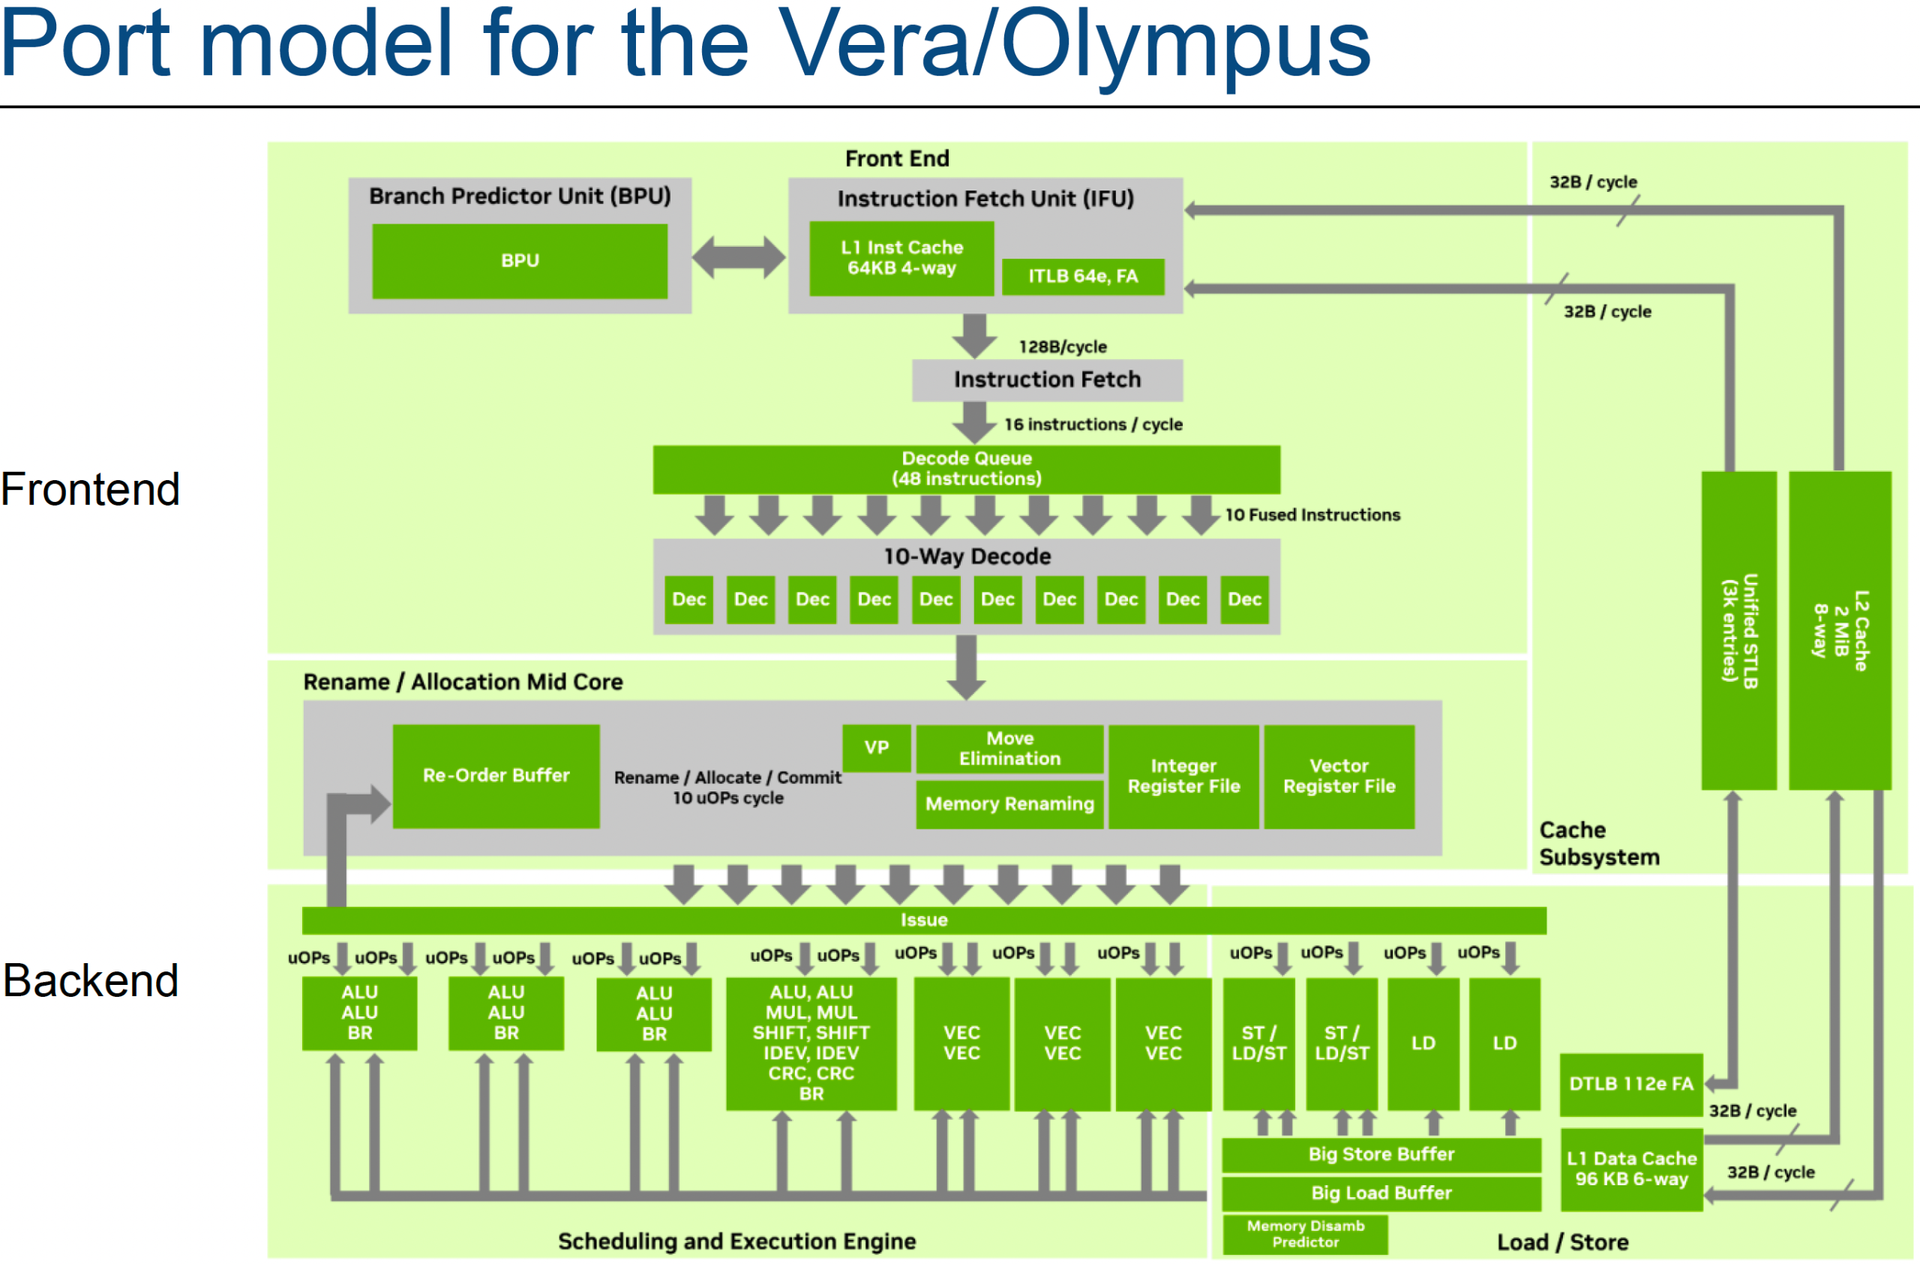
이러한 성능 차이를 만드는 근간에는 바로 'Olympus'라 불리는 독자적인 코어 기술이 있습니다. 이전 세대인 Grace CPU가 Arm에서 개발한 기성품인 'Neoverse V2' CPU 코어에 의존했던 것과는 차원이 다른 행보입니다. 엔비디아는 코어당 성능을 극대화하고 높은 총 처리량(aggregate throughput)을 보장하기 위해 자체 설계한 'Olympus' 코어를 Vera에 탑재했습니다. 이 Olympus 코어의 내부 구조를 살펴보면 그 기술적 깊이를 알 수 있습니다. 10-wide 디코더(10-wide decoder)를 갖춘 넓은 프런트엔드(wide front end)를 기반으로, 뉴럴 분기 예측기(neural branch predictor)와 깊은 비순차적 실행 엔진(deep out-of-order execution engine)이 탑재되었습니다. 여기에 6개의 벡터 실행 유닛(six vector execution units), 4개의 로드 파이프라인(four load pipelines), 2개의 스토어 파이프라인(two store pipelines)이 조화를 이루며, 이 모든 과정은 대용량 프라이빗 캐시(large private caches)와 진보된 프리페치 메커니즘(advanced prefetch mechanisms)의 뒷받침을 받습니다.
엔비디아의 설계 철학은 '단순히 많은 코어'가 아닌 '강력한 코어'에 집중되어 있습니다. 소켓당 가능한 최대 코어 수를 늘리는 대신, 엔비디아는 의도적으로 88개의 고성능 범용 코어(88 high-performance general-purpose cores)를 선택했습니다. 대신 이 코어들에 엔비디아만의 독자적인 '공간적 멀티스레딩 기술(spatial multith팅 technology)'을 적용하여 총 176개의 스레드(176 threads in total)를 지원하도록 구현했습니다. 이는 Vera의 핵심 설계 목표 중 하나였던 '최대 가능한 싱글 스레드 성능의 극대화'를 달라는 결단이 반영된 결과입니다.
이번 소식은 Tom's Hardware의 심층적인 보도를 통해 더욱 자세히 알려졌으며, 관련 상세 정보는 Tom's Hardware 앱(Apple App Store 및 Google Play Store에서 다운로드 가능)을 통해 스마트 검색 및 개인화된 피드 기능을 통해 지속적으로 업데이트될 예정입니다. 엔비디아가 구현한 Olympus 코어의 혁신이 실제 데이터센터 환경에서 어떤 변화를 몰고 올지, 앞으로의 추이를 계속해서 주목해 보겠습니다.
2부: 10-wide 디코더와 88개 코어의 결합, 독자 설계된 'Olympus' 아키텍처 분석#
엔비디아(Nvidia)가 선보인 차세대 CPU 'Vera'의 핵심은 단순히 코어의 숫자를 늘리는 것에 있지 않습니다. CPU 설계의 본질적인 딜레마를 어떻게 해결했느냐가 이번 아키텍처의 성패를 갈랐습니다. Tom's Hardware Premium과의 인터뷰에서 엔비디한의 Vera CPU 마케팅을 이끄는 Hannah Coutand는 "CPU 설계는 정말로 트레이드오프(trade-offs)의 게임이다"라고 정의했습니다. 그녀의 설명에 따르면, 다수의 코어를 배치하기 위해 다이를 최대한 활용하다 보면, 역설적으로 각 코어의 IPC(Instructions Per Clock, 클럭당 명령어 처리 수)를 극대화할 공간이 부족해지는 상황이 발생하게 됩니다. 즉, 코어의 개수와 개별 코어의 강력한 성능 사이에서 정교한 균형을 잡는 것이 이번 'Olympus' 아키텍처의 핵심 과제였습니다.
엔비디아는 Vera를 단순한 범용 CPU로 정의하지 않습니다. 이 프로세서는 agentic AI 및 기타 AI 관련 워크로드를 위해 최적화된 특수 목적형 설계에 가깝습니다. 원래 Olympus 마이크로아키텍처는 데이터 처리 애플리케이션을 염두에 두고 구상되었으나, 결과적으로 이 아키텍처가 가진 높은 코어당 성능(high per-core performance), 높은 메모리 대역폭(high memory bandwidth), 그리고 낮은 메모리 액세스 지연 시간(low memory access latency)이라는 특성이 agentic AI 워크로드가 요구하는 핵심 속성과 정확히 일치했기 때문입니다. Hannah Coutand는 "Vera의 전략과 포지셔닝은 매우 명확하며, 결코 범용 CPU가 아니다"라고 강조하며, 클라우드 데이터 센터의 웹 서버와 같이 일반적인 용도를 원한다면 Vera보다 더 적합한 다른 선택지가 있을 것이라고 분명히 선을 그었습니다.
이번 아키텍처의 성능을 증명하기 위해 엔비디아 연구진은 매우 정밀한 벤치마크를 수행했습니다. 엔비디아의 커스텀 Olympus 마이크로아키텍처의 계산 능력을 측정하고, 기존 Arm Neoverse V2 기반의 Grace 프로세서와 비교하기 위해 오픈 소스 선형 대수 라이브러리인 OpenBLAS의 어셈블리 커널을 기반으로 한 DGEMM(double-precision general matrix multiplication, 배정밀도 일반 행렬 곱셈) 워크로드를 사용했습니다. 특히 주목할 점은 하드웨어의 잠재력을 끌어올리는 '소프트웨어 최적화'의 위력입니다.
구체적인 기술적 지표와 벤치마크 결과는 다음과 같습니다:
- Olympus 아키텍처의 설계 목표: 단순한 코어 수 확장이 아닌, 높은 코어당 속도, 높은 메모리 대역폭, 낮은 지연 시간을 구현하여 agentic AI 워크로드에 최적화된 성능을 제공하는 것을 목표로 합니다.
- 실험 환경 및 방법론: OpenBLAS 라이브러리의 커널을 활용하여 128 × 128 행렬 곱셈 문제를 수행하는 miniKernelGEMM이라는 독립형 벤치마크를 사용했으며, 해당 문제는 두 프로세서 모두의 L1 캐시 내에 들어갈 수 있는 규모로 설정되었습니다.
- 기존 Grace CPU(Neoverse V2)의 성능: Neoverxim V2 커널을 사용했을 때, Grace CPU는 4.51 IPC 및 사이클당 13.03 FP64 연산(operations per cycle)을 달성했습니다.
- Vera의 기본 성능(동일 코드 적용 시): 동일한 코드를 사용했을 때, Vera는 5.43 IPC 및 사이클당 15.69 FP64 연산을 기록하며 기존 대비 약 20%의 성능 향상을 보여주었습니다.
- 소프트웨어 최적화 후의 극적인 변화: Olympus에 특화되어 최적화된 커널을 사용하자, Vera의 성능은 7.53 IPC 및 사이클당 21.75 FP64 연산까지 치솟았습니다. 이는 특정 워크로드에서 이전 세대 대비 코어당, 클럭당 성능이 무려 67%나 향상되었음을 의미합니다.
이러한 수치는 엔비디아가 단순한 하드웨어 제조사를 넘어, 소프트웨어와 하드웨어의 긴밀한 결합을 통해 성능의 한계를 돌파하고 있음을 보여줍니다. OpenBLAS에는 기존 Grace 프로세서를 구동하는 Neoverse V2 코어에 맞춤화된 커널은 존재했지만, Olympus를 위해 특별히 설계된 커널은 부재한 상태였습니다. 그러나 연구진이 Olympus의 특성을 반영하여 최적화된 커널을 적용하는 순간, 성능은 단순한 개선을 넘어 폭발적인 성장을 기록했습니다. 결국 Vera의 진정한 가치는 강력한 10-wide 디코더와 88개 코어라는 하드웨어 스펙 자체에 머무는 것이 아니라, 이를 완벽하게 활용할 수 있는 소프트웨어 최적화 기술이 결합될 때 비로소 완성된다고 할 수 있습니다.
3부: 범용성을 넘어 에이전틱 AI 시대를 겨냥한 엔비디아의 맞춤형 CPU 전략#
엔비디아가 선보인 차세대 CPU 'Vera'의 핵심은 단순히 하드웨어의 스펙을 높이는 것에 그치지 않습니다. 그 중심에는 독자적인 'Olympus' 코어의 혁신적인 마이크로아키텍처 설계가 자리 잡고 있습니다. 기존의 Grace 프로세서에 적용되었던 Neoverse V2 마이크로아키텍처는 4개의 128-bit SIMD(Single Instruction, Multiple Data) 파이프라인을 통해 클록당 총 16개의 FP64(64비트 부동 소수점) 연산을 수행할 수 있는 구조였습니다. 반면, 엔비디아가 새롭게 선보인 Olympus 코어는 이러한 파이프라인을 6개로 확장하였으며, 이를 통해 클록당 최대 24개의 FP64 연산을 실행할 수 있게 되었습니다. 이는 산술적으로 하드웨어의 연산 잠재력이 기존 대비 무려 50%나 향상되었음을 의미합니다.
하지만 하드웨어의 물리적인 성능 향상이 곧바로 실질적인 성능의 비약적인 상승으로 이어지는 것은 아닙니다. 중요한 것은 이 강력한 하드웨어를 얼마나 효율적으로 활용하느냐 하는 '소프트웨어 최적화'의 문제입니다. 엔비아가 SC26에서 발표한 튜토리얼에 따르면, 기존의 Neoverse V2에 최적화된 커널을 Vera에 그대로 적용했을 경우, Grace의 피크(Peak) FP64 처리량의 81.4%를 활용하던 효율이 Vera의 연산 능력에서는 약 66.5% 수준으로 오히려 떨어지는 현상이 관찰되었습니다. 이는 새로운 Olympus 아키텍처의 확장된 자원을 기존 방식으로는 온전히 활용하지 못하고 있음을 시사하는 중요한 지표입니다 man습니다.
이를 극복하기 위해 엔비디아 연구진은 Olympus 마이크로아키텍처에 최적화된 새로운 접근법을 도입했습니다. 구체적으로는 매트릭스 타일 조직화(Matrix tile organization), 레지스터 할당(Register allocation), 그리고 명령어 스케줄링(Instruction scheduling) 방식에 대대적인 변화를 주었습니다. 이러한 정밀한 소프트웨어 튜닝 결과, 연구진은 Vera의 피크 FP64 처리량의 90.6%라는 놀라운 수치를 달성하는 데 성공했습니다. 즉, 하드웨어의 구조적 특성에 맞춘 소프트웨어의 최적화가 뒷받침될 때 비로소 Olympus 코어가 가진 진정한 잠재력이 해방될 수 있음을 증명한 것입니다.
물량 공세식의 하드웨어 확장을 넘어, 엔비디아는 이제 데이터 센터 GPU의 보조 역할을 수행하던 CPU의 범주를 벗어나 독자적인 서버 CPU 시장을 정조준하고 있습니다. 물론 현재 기존 Arm 기반 데이터 센터 프로세서용으로 개발된 소프트웨어들도 별도의 최적화 없이 Olympus 코어의 혜택을 어느 정도 누릴 수는 있습니다. 그러나 SC26 벤치마크 결과가 보여주듯, Olympus 코어의 실행 자원을 100% 활용하기 위해서는 특정 애플리케이션들에 대한 미세 조정(Fine-tuning)이 반드시 필요할 것으로 보입니다. 물론 이러한 최적화의 이점이 매트릭스 곱셈(Matrix multiplication) 이외의 다른 워크로드에서도 얼마나 극적으로 나타날지는 향후 지켜봐야 할 과제로 남아 있습니다.
엔비디아가 단독 서버 CPU 시장을 추격함에 있어 가장 큰 숙제는, 지난 수십 년간 Intel과 AMD가 구축해 온 것처럼 성능에 결정적인 영향을 미치는 소프트웨어들이 Olympus 아키텍처의 특수한 구조적 특징을 완벽하게 활용하도록 만드는 것입니다. 다행히 엔비디아는 이미 CUDA 플랫폼을 통해 파트너 및 에코시스템 개발 분야에서 매우 깊은 경험과 노하우를 축적해 왔습니다. 따라서 Vera가 시장에 널리 보급됨에 따라, 엔비디아가 보유한 강력한 생태계 조성 경험은 향후 이 CPU들을 위한 소프트웨어 최적화를 가속화하는 데 결정적인 역할을 할 것으로 기대됩니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 기존 방식 (Grace / Neoverse V2) | 신규 변화 (Vera / Olympus) | 핵심 차이 및 혁신 포인트 |
|---|---|---|---|
| SIMD 파이프라인 수 | 4개의 128-bit 파이프라인 | 6개의 128-bit 파이프라인 | 파이프라인 수 50% 확장 |
| 클록당 FP64 연산량 | 총 16 FP64 operations | 총 24 FP64 operations | 연산 처리 처리량(Throughput) 증대 |
| 소프트웨어 최적화 효율 | Neoverse V2 커널 기준 81.4% 활용 | Olympus 최적화 커널 기준 90.6% 활용 | 정밀한 튜닝을 통한 자원 활용 극대화 |
| 주요 최적화 기술 | 기존 Arm 기반 표준 커널 사용 | 매트릭스 타일, 레지스터, 스케줄링 재설계 | 아키텍처 맞춤형 소프트웨어 전략 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
🚀 엔비디아 CPU 전환을 위한 체크리스트
- [ ] 현재 사용 중인 워크로드가 매트릭스 곱셈(Matrix Multiplication)에 집중되어 있는가?
- [ ] 기존 Arm 기반 소프트웨어를 Olympus 아키텍처에 맞춰 미세 조정(Fine-tuning)할 준비가 되었는가?
- [ ] 새로운 레지스터 할당 및 명령어 스케줄링 방식에 대응하는 컴파일러 업데이트가 계획되어 있는가?
❓ 자주 묻무는 질문 (FAQ)
Q1. 기존에 사용하던 Arm 기반 데이터 센터용 소프트웨어를 그대로 Vera CPU에서 사용할 수 있나요? A1. 네, 가능합니다. 기존에 최적화된 소프트웨어도 Olympus 코어의 기본 성능 향상에 따른 혜택을 받을 수 있습니다. 다만, Olympus 코어가 가진 강력한 연산 자원을 최대한으로 끌어내기 위해서는 매트릭스 타일 조직화나 레지스터 할당 등을 포함한 아키텍처 맞춤형 최적화 작업이 병행되어야 최고의 성능을 경험할 수 있습니다.
Q2. 이번 성능 향상은 매트릭스 연산에만 국한된 결과인가요? A2. 이번에 발표된 90.6%의 높은 활용률 수치는 매트릭스 곱셈 워크로드를 중심으로 입증된 결과입니다. 매트릭스 연산 이외의 다른 범용적인 워크로드에서 Olympus 특화 최적화가 어느 정도의 추가적인 성능 이득을 가져올지에 대해서는 향후 지속적인 벤치마크와 검증이 필요합니다.
딥러너 (DeepLearner)이었습니다.


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성