
⚡ 결론 직답: Nvidia RTX Spark 기반 Asus ProArt GR1X는 $6,999라는 고가임에도 불구하고, 1초 미만의 반응 속도로 혁신적인 로컬 AI 에이전트 환경을 구현합니다.
📌 3줄 핵심 요약
- Asus ProArt GR1X(RTX Spark, 128GB)는 $6,999에 달하는 고가 모델로, 로컬 AI 데이터 센터 구축을 위한 강력한 성능을 제공함
- Qwen 3.8 27B 모델 테스트 결과, RTX Spark는 AMD Ryzen AI Max 395 탑재 모델 대비 월등히 빠른 초기 반응 속도(TTFT)를 기록함
- Nvidia PAIR 기능을 통해 MacBook Pro나 RTX 5070 Ti 데스크톱과 AI 연산 자원을 공유하는 멀티 디바이스 에코시스템 구축 가능
📅 데이터 기준일: 2026-11-18 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
1부: 노트북을 넘어 미니 PC로, RTX Spark가 선사하는 새로운 컴퓨팅 종의 탄생#
지난 한 달 동안 노트북 환경에서 Nvidia의 RTX Spark를 테스트하며, 저는 마치 완전히 새로운 종(species)의 컴퓨터가 탄생하는 순간을 목격하는 듯한 기분을 느꼈습니다. 휴대 가능한 섀시 안에 이 강력한 로컬 AI 성능과 압도적인 연산 능력을 담아낸다는 것은, 그 자체로 진정한 '올인원(everything) 머신'을 구현하기 위한 매우 타당한 선택처럼 보였기 때문입니다.
하지만 이 N1X 칩을 노트북이라는 틀에서 꺼내, Asus ProArt GR1X와 같은 데스크톱 형태의 미니 PC에 탑재하고 최소 $4,499(제가 테스트 중인 128GB 버전의 경우 무려 $6,999)라는 가격표를 붙이는 순간, 이야기는 완전히 달라집니다. 전원에 연결된 상태의 미니 PC는 노트북 모델보다 더 빠른 속도를 보여주지만, 이제 이 칩의 경쟁 상대는 더 이상 MacBook Pro가 아닙니다. 이 칩은 이제 더욱 냉혹하고 강력한 성능을 다투는 데스크톱 시장, 즉 Nvidia가 어떤 면에서는 자기 자신과 싸워야 하는 그 치열한 전장으로 뛰어든 것입니다.
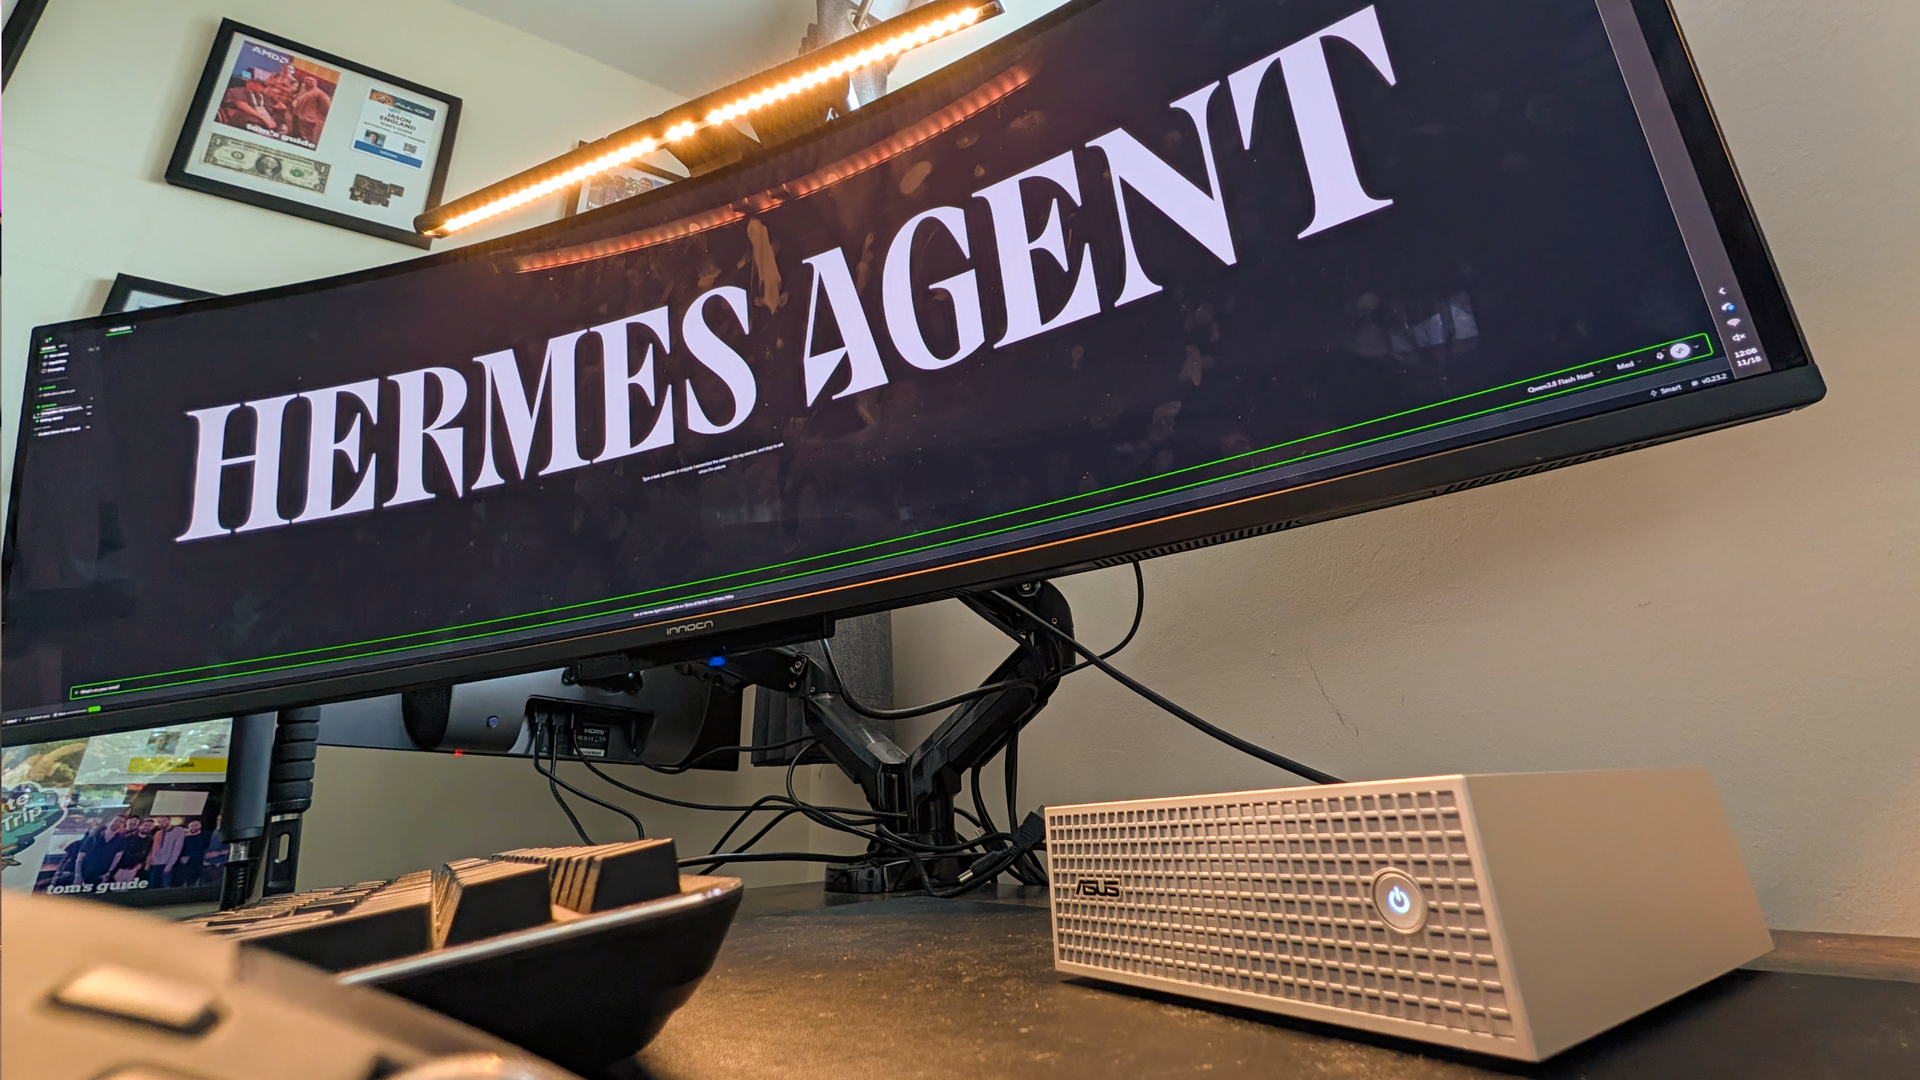
현재 저의 테스트 벤치에는 두 대의 128GB급 헤비급 모델이 자리 잡고 있습니다. '그린 코너'에는 RTX Spark와 128GB 메모리를 탑재한 Asus ProArt GR1X가 있으며, '레드 코너'에는 AMD의 Ryzen AI Max 395를 장착하고 동일하게 128GB 메모리를 갖춘 Geekom A9 Mega가 있습니다. 주목할 점은 Geekom 모델이 훨씬 $3,000나 저렴하다는 사실입니다. 여기에 제가 Nvidia가 데스크톱 시장에서 스스로와 경쟁하고 있다고 말씀드린 것을 증명하기 위해, 약 $4,000 정도 더 저렴한(PC Part Picker 기준) 저의 커스텀 RTX 5070 Ti 데스크톱까지 대결 구도에 포함시켰습니다.
이번 리뷰에서는 두 가지 핵심적인 내용을 전달하고자 합니다. 첫째는 이 시스템을 구매하려는 분들에게 가장 중요한 벤치마크 수치를 보여드리는 것입니다. 이 정도의 거액을 투자하는 만큼, 그에 걸맞은 투자 수익(Return)을 얻을 수 있는지 확인시켜 드리고 싶습니다. 둘째는 이 기기와 함께한 저의 실제 경험입니다. RTX Spark는 노트북에 있을 때 가장 매력적일 수 있지만, 미니 PC 형태(특히 항상 켜져 있는 상태)로 활용할 때 비로님 '나만의 로컬 데이터 센터'를 구축할 수 있는 가능성이 열리기 때문입니다.
제가 상상한 '로컬 에이전트'의 시나리오는 이렇습니다. 구독료를 지불할 필요 없이, 항상 켜져 있는 초보안(hyper-secure) 가정용 브레인 역할을 수행할 128GB 미니 PC를 구매하는 것입니다. 이 기기가 Hermes를 통해 Qwen 3.8 Flash와 같은 로컬 모델을 구동하며, 아침 이메일을 자동으로 정리하고, 뉴스를 위해 웹을 스크래핑하며, Home Assistant와 연동되어 로봇 청소기에게 주방 청소를 지시하는 식입니다. 이를 측정하기 위해 저는 두 기기에 LM Studio를 사용하여 Qwen 3.8 27B 모델로 'Apollo 17 Writing Test(속도 및 반응)', 'Battle of Waterloo Summary(속도 및 반응)', 그리고 'Agentic Coding Task(속도 및 반응)'라는 세 가지 표준 생성 및 에이전트 작업 테스트를 진행했습니다.
결과는 놀라웠습니다. Nvidia의 칩은 마치 실버스톤(Silverstone) 서킷의 에이펙스(apex)를 정교하게 통과하는 드라이버처럼 날카로운 반사 신경을 보여주었습니다. 1초 미만의 반응 속도(TTFT)는 대화형 에이전트를 믿기 어려울 정도로 생생하게 만들어 주었습니다. 실제로 이 기기를 텔레그램(Telegram) 앱과 연동된 셀프 호스팅 에이전트로 변신시켰을 때, 제가 아내와 전화로 대화를 나누는 동안 이 기기가 지루한 아침 업무들을 알아서 처리해 주는 경험을 할 수 있었습니다. 또한 Nvidia PAIR 기능을 활용하면 집 안의 모든 지원 기기에서 AI 연산 능력을 공유할 수 있습니다. 예를 들어, MacBook Pro에서 내린 프롬프트가 긴 작업이 필요할 때는 Spark 머신을 깨우고, 짧은 작업은 RTX 5070 Ti 데스크톱이 처리하도록 분산시키는 식입니다.
물론 AMD 기반의 Geekom A9 Mega 역시 충분히 훌륭한 성능을 보여줍니다. 초당 24토큰(TPS)이라는 속도는 인간이 읽는 속도보다 빠르며, 다만 Nvidia에 비해 아주 미세하게 '헛기침'을 하는 듯한 지연이 느껴질 뿐입니다. 한편, 커스텀 데스크톱 PC의 경우 기술적으로는 가능하지만, 시스템 메모리를 하나의 거대한 통합된 바다처럼 사용하는 것이 아니라 서로 다른 풀(pool)로 취급하기 때문에 몇 가지 제약 사항이 존재합니다.
2부: $6,999의 가치 증명하기: RTX Spark와 AMD Ryzen AI Max 395의 성능 격돌#
AI 모델의 진정한 성능은 모델이 GPU의 VRAM(비디오 램) 내에 얼마나 안정적으로 상주할 수 있느냐에 달려 있습니다. 제가 이번 테스트에서 사용한 27-billion-parameter(270억 파라미터) 규모의 모델은, 설령 강력한 압축 과정을 거쳤다 하더라도 RTX 5070 Ti에 탑재된 16GB의 VRAM을 상당 부분 점유하게 됩니다. 문제는 GPU의 VRAM 용량이 한계에 다다르는 순간 발생합니다. 남은 데이터를 일반 시스템 RAM으로 넘기는 '오프로딩(offload)' 현상이 발생하면, 데이터 전송 병목 현상으로 인해 60+ TPS(초당 토큰 수)에 달하던 놀라운 속도는 순식간에 4-5 TPS라는 처참한 수준으로 급락하게 됩니다.
이 현상을 비유하자면, 저의 커스텀 RTX 5070 Ti 데스크톱은 마치 '100피트 길이의 짧은 트랙을 달리는 페라리'와 같습니다. 속도 자체는 믿을 수 없을 만큼 빠르지만, 트랙(VRAM)이 너무 짧아서 벽에 부딪히기 전까지는 일정 거리 이상 나아갈 수 없는 구조인 셈이죠. 반면, 128GB의 대용량 메모리를 탑재한 미니 PC들은 최고 속도는 페라리보다 낮을지 모르나, 거대한 화물(대규모 AI 모델)을 싣고도 탈선 없이 목적지까지 운반할 수 있는 '화물 열차'와 같은 든든함을 보여줍니다.
이번 성능 비교의 핵심적인 기술적 차이점과 테스트 결과는 다음과 같습니다.
- VRAM 병목 현상과 메모리 구조: RTX 5070 Ti의 16GB VRAM은 마치 '비행기용 작은 트레이 테이블'처럼 좁은 면적을 가진 반면, RTX Spark(Asus ProArt GR1X)의 128GB 통합 메모리는 거대한 '다이닝 테이블'과 같아 대규모 생성형 워크로드를 통째로 수용할 수 있습니다.
- 벤치마크 성능 격돌: ComfyUI(Minimax v3)를 이용한 로컬 비디오 생성 테스트에서 RTX Spark는 동일한 작업을 AMD Ryzen AI Max 395(Geekom A9 Mega)보다 무려 3배 가까이 빠른 속도로 처리해내며 압도적인 우위를 점했습니다.
- 주요 테스트 항목: Handbrake(4K to 1080p Transcode), Procyon Stable Diffusion XL, Procyon AI Computer Vision, Procyon Text Gen (Llama 3.1) 등 다양한 워크로드를 통해 연산 능력을 검증했습니다.
- Nvidia의 독보적 기술력: Nvidia의 독자적인 Tensor cores와 초효율적인 NVFP4 precision 포맷은 AMD의 Strix Halo를 완전히 압도하며, 단순한 수치를 넘어선 기술적 격차를 증명했습니다.
이 결과는 그야말로 '학살(Bloodbath)'에 가까운 수준이었습니다. Nvidia의 전용 Tensor cores와 NVFP4 정밀도 포맷이 보여준 퍼포먼스는 AMD의 Strix Halo 기반 시스템을 완전히 따돌렸습니다. 만약 여러분이 촉박한 마감 기한을 앞두고 로컬 비디오 에셋을 생성해야 하는 3D 아티스트, 인디 게임 개발자, 혹은 광고 에이전시 디렉터라면, 렌더링 시간은 곧 비용과 직결됩니다. 이러한 전문적인 작업 환경에서는 Asus ProArt GR1X가 보여주는 압도적인 속도가 그 비싼 가격을 스스로 증명해냅니다.
다만, 전문가용 기기로서 한 가지 아쉬운 점을 꼽자면 Asus 측의 설계입니다. 크리에이터를 위한 머신임에도 불구하고 SD 카드 리더기를 탑재하지 않은 점은 뼈아픕니다. 사진 데이터를 옮기기 위해 다시 '동글 지옥(dongle hell)'으로 빠져야 하는 번거로움을 감수해야 하기 때문입니다.
물론, 일반 사용자들에게 이 기기가 주는 의미는 조금 다를 수 있습니다. 개인적으로 저는 인간의 창의성과, 적절한 프롬프트를 입력해 AI 결과물을 뽑아내는 작업 사이에는 큰 간극이 있다고 생각합니다. 비록 Adobe Creative Suite가 RTX Spark에 최칭되어 최적화되는 등의 발전이 있지만, 저 역시 이 기기를 유튜브 인트로 제작이나 아내의 낙서를 활용한 간단한 실험 외에 특별한 용도로 사용하지는 않았습니다.
결국, $6,999라는 거금을 들여 AI 전용 머신을 구매한다는 것은, 단순히 성능을 사는 것이 아니라 '모든 것을 할 수 있는 진정한 올인원 머신'을 소유하겠다는 의지의 표현입니다. 3DMark Time Spy Extreme 점수와 DLSS 적용 전후의 프레임 레이트를 확인해 보면, 이 막대한 비용을 지불할 가치가 있는 게임 성능까지 갖추었는지 확인할 수 있습니다. 이 기기가 단순한 AI 도구를 넘어, 우리가 꿈꾸는 '모든 것을 수행하는 머신(everything machine)'이 될 수 있을지는 결국 이 강력한 성능에 얼마만큼의 가치를 부여하느냐에 달려 있습니다.
3부: 로컬 AI 에이전트의 미래: Nvidia PAIR를 활용한 개인용 데이터 센터 구축#
최근 테크 업계의 화두는 단연 '로컬 AI'입니다. 클라우드에 의존하지 않고 내 손안의 기기에서 직접 데이터를 처리하는 시대, 그 정점에 서 있는 것이 바로 Nvidia RTX Spark 시리즈입니다. 하지만 우리가 꿈꾸는 '개인용 데이터 센터'의 실현에는 아주 냉정한 현실적 계산이 필요합니다. Asus ProArt GR1X와 같은 RTX Spark 미니 PC는 단순한 컴퓨터를 넘어, 일종의 '로컬 토큰 생성기(localized token generators)'라고 정의할 수 있습니다. 이 기기는 PC의 탈을 쓰고 있지만, 그 본질은 AI 연산을 위해 설계된 특수 목적 장치에 가깝기 때문입니다.
물론 성능 측면에서 보면 이 기기는 매우 경이롭습니다. 특히 게임 성능을 살펴보면, Black Myth Wukong(검은 신화: 오공)을 1440p Cinematic 설정에서 DLSS 없이 구동하거나, Cyberpunk 2077(사이버펑크 2077)을 1440p Ray Tracing Ultra 설정에서 DLSS 없이 구동할 때의 퍼포먼스는 놀랍습니다. 특히 DLSS 4.5 Balanced와 Dynamic Frame Gen 기술을 적용했을 때의 부드러움은 압도적입니다. 이는 AMD의 통합 GPU 성능을 가볍게 압도하며, 고사양 1440p 게이밍을 충분히 가능케 하는 수준입니다. 하지만 여기서 우리는 '데스크탑의 현실'이라는 냉혹한 벽을 마주하게 됩니다.
가장 뼈아픈 지점은 바로 '가성비'와 '효율'의 문제입니다. 만약 여러분이 AI 작업보다 게임 성능을 최우선으로 생각한다면, Asus ProArt GR1X의 절반 가격만 투자해도 구축할 수 있는 표준 RTX 5070 Ti 데스크탑이 Spark의 네이tilde 성능을 두 배나 능가한다는 사실을 잊어서는 안 됩니다. 즉, RTX Spark는 게이머를 위한 기기가 아니라, 특정 목적을 가진 전문가를 위한 '치트 코드(cheat code)'에 가깝습니다. 만약 여러분이 이미 고도화된 AI 워크플로우를 보유하고 있으며, 대규모 크리에이티브 작업을 수행하는 전문가라면, 기다림의 시간을 획기적으로 줄여주는 이 기기의 속도 향상은 그만한 가치를 증명할 것입니다.
그렇다면 우리는 이 '비싼 AI 세금'을 지불할 가치가 있을까요? 만약 여러분의 목표가 클라우드 API 비용을 회피하고, 거대한 로컬 브레인을 구축하여 워크플로우를 자동화하는 것이라면 고민은 깊어질 것입니다. Geekom A9 Mega (Ryzen AI Max 395)와 같은 AMD 기반 시스템은 일상적인 작업에서 Nvidia 박스의 약 80% 수준의 성능을 보여주면서도, 훨씬 저렴한 비용으로 구축이 가능합니다. 결국 "Spark가 제공하는 압도적인 속도 차이가 과연 3,000달러($3,000)의 가치를 하는가?"라는 질문은 오직 사용자 본인의 판단에 달려 있습니다. 단순히 AI를 가끔 찍어 먹어보는 수준의 사용자라면, 비싼 부품 가격을 감수하더라도 차라리 전통적인 데스크탑을 구성하여 게이밍과 간헐적인 AI 작업에서 더 높은 '가성비(bang for your buck)'를 챙기는 것이 현명한 선택이 될 것입니다.
한편, 하드웨어 시장의 흐름은 더욱 복잡해지고 있습니다. 최근 Apple의 2,899달러($2,899)짜리 MacBook Pro는 통합 메모리 병목 현상(unified memory bottleneck) 문제를 드러내며 파워 유저들 사이에서 논란이 되고 있으며, 이는 Nvidia RTX Spark나 AMD Strix Halo로의 전환을 고민하게 만드는 요소가 되고 있습니다. 또한, AMD FSR 4 기술이 ROG Xbox Ally X20이나 Strix Halo에서 보여주는 성능 향상이 마치 '시각적 착각(optical illusion)'에 불과하다는 비판적인 시각도 존재합니다. 여기에 RAM 가격 담합 의혹인 'RAMageddon' 소송과 관련된 법적 공방까지 더해지며, 하드웨어 생태계는 그 어느 때보다 역동적이고 불확실한 시기를 지나고 있습니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | RTX Spark (Asus ProArt GR1X) | RTX 5070 Ti 데스크탑 | AMD 기반 시스템 (Geekom A9 Mega 등) | Apple MacBook Pro ($2,899) |
|---|---|---|---|---|
| 핵심 정체성 | 로컬 토큰 생성기 (AI 특화) | 고성능 게이밍 및 범용 PC | 가성비 중심의 일상/AI 작업 | 프리미엄 모바일 워크스테이션 |
| AI 워크플로우 | 압도적 속도 (치트 코드급) | 준수한 성능 (네이티브 2배) | 일상 작업의 80% 수행 가능 | 통합 메모리 병목 위험 존재 |
| 게이밍 성능 | 1440p 가능 (DLSS 활용 권장) | 최상급 네이티브 성능 제공 | AMD 통합 GPU 기반 성능 | (모바일 환경 중심) |
| 경제성/비용 | 매우 높음 (비싼 AI 세금) | 효율적 (Spark 가격의 1/2) | 매우 높음 (클라우드 비용 절감) | 높은 초기 투자 비용 |
| 추천 사용자 | 전문 AI 워크플로우 보유 전문가 | 게이밍이 주 목적인 사용자 | 효율적인 자동화 구현 희망자 | Apple 생태계 충성 사용자 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
🔍 나에게 맞는 AI PC 선택 체크리스트#
- [ ] 워크플로우 확인: 나의 AI 작업이 클라우드 API 비용을 지불할 만큼 빈번하고 대규모인가? (Yes $\rightarrow$ RTX Spark 고려)
- [ ] 예산 한도 설정: 성능 향상을 위해 $3,000 이상의 추가 비용(AI 세금)을 감당할 준비가 되었는가? (No $\rightarrow$ AMD 기반 시스템 고려)
- [ ] 용도 우선순위: 나의 주된 목적이 'AI 연산'인가, 아니면 '고주사율 게이밍'인가? (Gaming $\rightarrow$ RTX 5070 Ti 데스크탑 구축)
❓ 자주 묻는 질문 (FAQ)#
Q1. RTX Spark의 성능이 높다고 하는데, 왜 굳이 RTX 5070 Ti 데스크탑을 추천하나요? A1. 단순한 네이티브 깡성능(Native Performance) 측면에서 RTX 5070 Ti 데스크탑은 RTX Spark의 약 두 배에 달하는 성능을 보여줍니다. 심지어 구축 비용은 Asus ProArt GR1X의 절반 수준입니다. 따라서 게임이 주 목적이라면 훨씬 경제적이고 강력한 데스크탑이 유리합니다.Q2. AMD 기반의 Geekom A9 Mega 같은 기기는 AI 작업에 부적합한가요? A2. 부적합하다기보다는 '효율성'의 차이입니다. AMD 시스템은 일상적인 AI 작업의 약 80%를 충분히 수행할 수 있습니다. 만약 극도의 속도보다는 클라우드 API 비용을 아끼고 경제적인 로컬 환경을 구축하는 것이 목적이라면, AMD 시스템이 훨씬 뛰어난 가성비를 제공합니다.
딥러너 (DeepLearner)이었습니다.
🔗 원문 참고 및 출처: I spent a week with Nvidia's RTX Spark mini PC — it's brilliant, but unless you're Tony Stark, the AI tax is optional


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성