
⚡ 결론 직답: 약 1,042달러 규모의 중고 Nvidia V10/P100 GPU를 활용한 홈랩 구성으로, Qwen 3.6 35B 모델에서 초당 약 100토큰의 압도적인 추론 성능을 기록했습니다.
📌 3줄 핵심 요약
- Nvidia V100 GPU 3개를 활용하여 MoE 모델인 Qwen 3.6 35B에서 4K 컨텍스트 기준 초당 100.8토큰의 속도를 달성함
- 약 1,042달러의 저비용 구성으로 Q8 정밀도에서도 실시간 기준인 70tps를 상회하는 성능을 구현함
- GPU 확장은 메모리 용량 확보에는 유리하나 추론 속도 향상에는 한계가 있으며, P100 대비 에너지 효율이 약 2배 높음
📅 데이터 기준일: 2026-11-19 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
최근 AI 하드웨어 커뮤니티에서는 최신형 GPU를 구매하는 대신, 버려진 부품이라 불리는 'e-waste(전자 폐기물)'를 활용해 놀라운 성능을 끌어낸 한 홈랩 빌더의 실험 결과가 큰 화제를 모으고 있습니다. 단돈 1,042달러(한화 약 140만 원 상당)라는 저렴한 비용으로 구축된 이 커스텀 시스템은, 중고 Nvidia V100 GPU 3개를 활용해 Qwen 3.6 35B 모델에서 초당 무려 100토큰(100 tokens per second)이라는 경이로운 추론 속도를 달성했습니다. 이는 최신 고가 하드웨어나 클라우드 기반의 추론 API에 필적할 만한 수준입니다. 반면, 모델 크기가 조금 더 작은 Qwen 3.6 27B 모델의 경우 동일한 플랫폼에서 초당 약 24토큰 정도의 속도를 보여주었으며, 주목할 점은 V10한 GPU가 동일한 작업량 기준, 기존의 P100 GPU를 사용할 때보다 에너지 소비를 약 절반 수준으로 줄였다는 점입니다.
이번 실험의 상세한 내용은 "Scaling ‘E-Waste’: LLMs on Multiple Decommissioned GPUs"라는 제목의 블로그 포스트를 통해 공개되었으며, Reddit의 r/homelab 커뮤니티를 중심으로 공유되었습니다. 이 실험은 단순한 호기심을 넘어, Supermicro의 듀얼 Xeon 보드 하나에 K80, P100, 또는 V100-16GB 카드를 1개부터 3개까지 장착한 총 9가지의 서로 다른 빌드를 비교 분석했습니다. 테스트에는 llama.cpp 프레임워크가 사용되었으며, Qwen 2.5, Gemma 4, 그리고 이번 실험의 주인공인 Qwen 3.6을 포함하여 130개가 넘는 방대한 LLM 테스트가 진행되었습니다. 테스트 범위 또한 Q4, Q8, F16과 같은 다양한 양자화(Quantization) 정밀도와 4K에서 128K에 이르는 광범위한 컨텍스트 크기를 모두 아우르며, 각 GPU 실행 시 발생하는 에너지 소비량까지 정밀하게 기록되었습니다.
여기서 언급된 'e-waste'란 기업 환경에서 수명을 다해 퇴역(decommissioned)한 엔터프라이즈급 GPU를 의미합니다. 이들은 최신형 GPU와 비교하면 성능이 다소 부족할 수 있지만, 매우 저렴한 가격 덕분에 홈랩 사용자들에게는 매력적인 선택지가 됩니다. 이번 테스트는 지난 7월, 15개의 'e-waste' GPU를 대상으로 진행했던 이전 실험의 후속 연구로 진행되었습니다. 실험의 일관성을 위해 메인보드와 CPU 구성은 모든 빌드에서 동일하게 유지되었습니다. 구체적으로는 Supermicro X10DRG-Q 메인보드에 12코어를 탑재한 Intel Xeon E5-2687W CPU 두 개가 장착되었으며, 전원 공급 장치(PSU)는 Corsair HX1500i 모델이 사용되었습니다.
실험에서 성능의 척도가 된 기준은 사용자가 체감할 수 있는 '실시간 상호작용(realtime interaction)'이며, 이는 초당 70토큰(70 tokens per second)을 기준으로 설정되었습니다. 특히 이번 실험에서 왜 하필 3개의 GPU를 사용했는지에 대한 흥란로운 이유도 밝혀졌습니다. 이번 테스트의 핵심 모델인 Qwen 3.6 35B의 경우, 8비트 양자화(Q8)를 적용했을 때 GPU 1개나 2개만으로는 모델을 구동하는 데 실패했기 때문입니다. 즉, 고성능 추론을 위해서는 일정 수준 이상의 GPU 개수 확보가 필수적임을 보여줍니다.
물론 이번 실험에 사용된 비용 산정에는 몇 가지 주의사항이 있습니다. 빌더가 제시한 가격은 현재 eBay 등에서 구할 수 있는 실시간 시세와 100% 일치하지 않을 수 있습니다. 또한, 전체 시스템 구축 비용에는 CPU 두 개 중 하나에 대한 비용만 포함되었으며, RAM(메모리), 저장 장치(SSD/HDD), 케이스, 그리고 냉각 솔루션(쿨링)에 들어간 비용은 제외된 수치입니다. 그럼에도 불구하고, 폐기된 GPU를 스케일링하여 성능을 극대화하는 이 실험은 저비용 고효율의 AI 인프라 구축에 대한 새로운 가능성을 제시하고 있습니다.
2부: Qwen 3.6 35B 벤치마크: MoE 구조가 만들어낸 초고속 토큰 생성 성능#
안녕하세요, 테크 에디터 딥러너(DeepLearner)입니다. 지난 1부에서 중고 GPU를 활용한 놀라운 가성비의 홈랩 구축 사례를 살펴보았다면, 이번 2부에서는 실제 성능이 어느 정도인지 그 압도적인 벤치마크 수치를 심층 분석해보려 합니다. 이번 테스트의 핵심은 단순히 '돌아간다'는 수준을 넘어, 최신 인공지능 모델의 구조적 특징이 구형 하드웨어에서 어떻게 폭발적인 성능으로 전환되는지를 보여주는 데 있습니다.
이번 실험에 사용된 GPU 세트의 가격은 $655.16(두 장 한 쌍 기준 $436.77)라는 놀라운 저렴함을 자랑합니다. 하지만 저렴한 만큼 감수해야 할 기술적 난관도 존재했습니다. 이 오래된 카드들은 기본적으로 "발열이 심하고 냉각 장치 없이 출고되는(run hot and ship without cooling)" 특성이 있어, 구축자는 각 카드마다 3D 프린터로 제작한 전용 블로워 덕트(blower duct)를 장착해야만 했습니다. 이러한 시행착오 끝에 현재는 독자적인 냉각 솔루션까지 개발된 상태입니다.
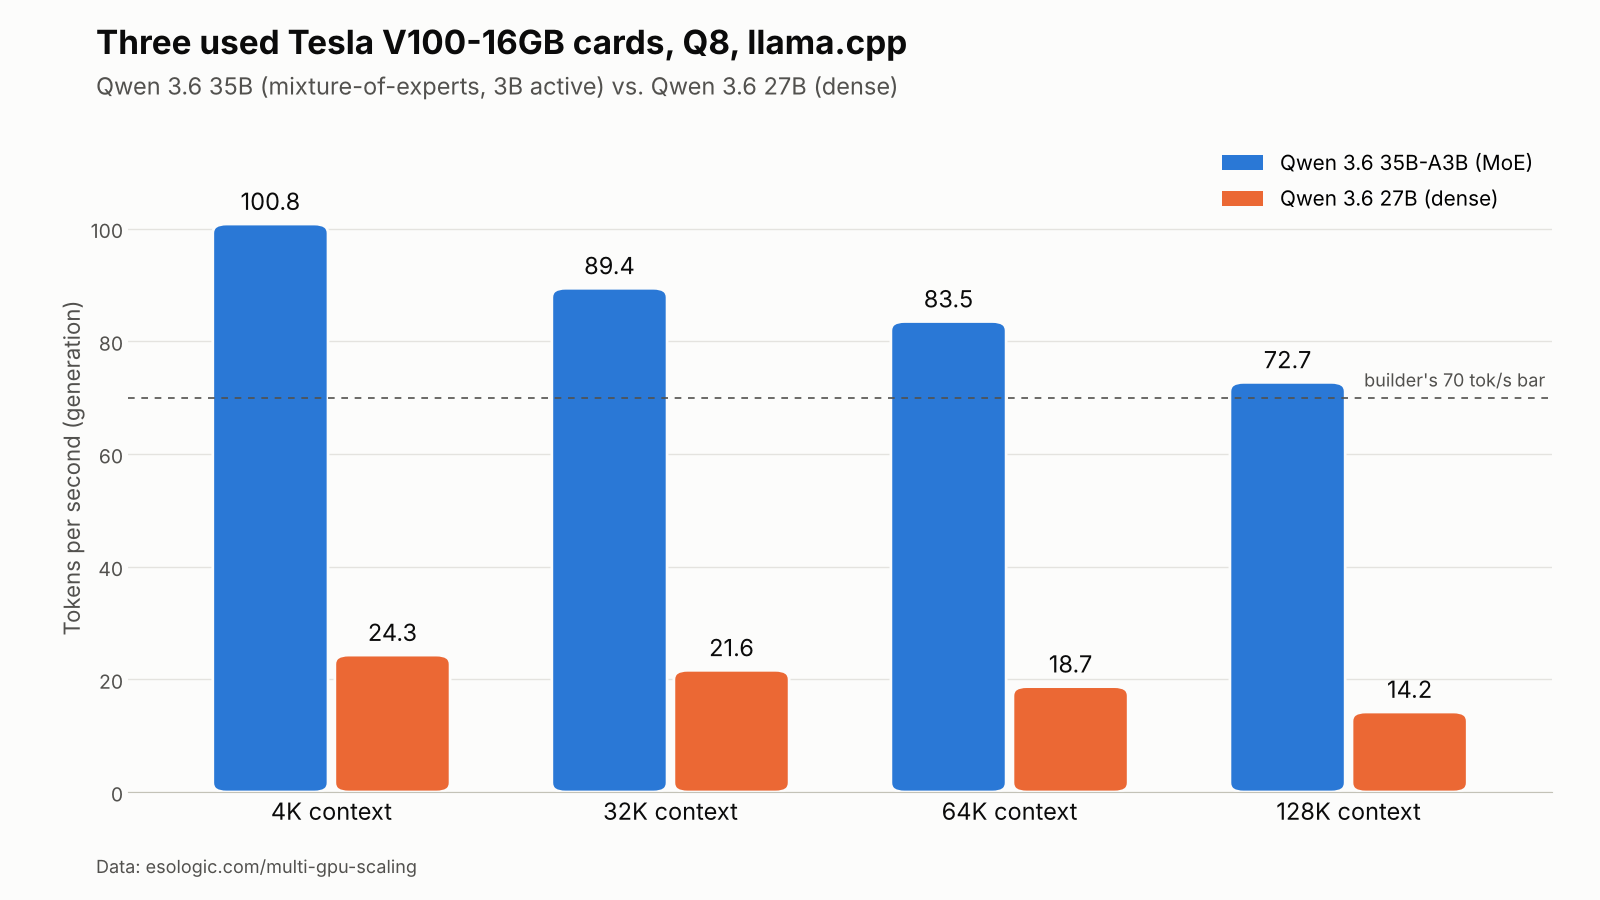
이번 벤치마크는 매우 정밀하게 설계되었습니다. 테스트는 4K, 32K, 64K, 그리고 128K의 컨텍스트(Context)를 미리 채운 상태에서, 512개의 토큰을 생성하는 과정을 총 10회 반복하여 측정되었습니다. 여기서 주목할 점은 테스트 대상인 Qwen 3.6 35B 모델이 MoE(Mixture-of-Experts) 구조를 채택하고 있다는 사실입니다. 이 모델은 전체 350억 개(35 billion)의 파라미터 중 토큰 하나를 생성할 때마다 약 30억 개(3 billion)의 파라미터만을 활성화합니다. 모든 수치는 Q8(8-bit quantization) 정밀도를 기준으로 측정되었습니다.
상세한 벤치마크 결과는 다음과 같습니다.
- Qwen 3.6 35B(MoE)의 컨텍스트별 성능: 컨텍스트 윈도우가 작은 4K 환경에서는 목표치인 70 tokens/s를 가볍게 상회하는 100.8 tokens/s를 기록했습니다. 컨텍스트가 128K까지 확장되어도 72.7 tokens/s를 유지하며, 여전히 실시간 상호작용 목표치인 70 tokens/s를 달성했습니다.
- 비-MoE(Dense) 모델과의 성능 격차: MoE 구조가 아닌 Qwen 3.6 27B 모델의 경우, 4K에서 24.3, 32K에서 21.6, 64K에서 18.7, 그리고 128K에서는 14.2 tokens/s라는 훨씬 낮은 수치를 기록했습니다. 결과적으로 MoE 구조가 컨텍스트 크기에 따라 약 4~5배 더 빠른 속도를 보였습니다.
- 유사 규모 Dense 모델과의 비교: 약 30B 규모의 다른 Dense 모델들을 테스트했을 때, 4K 기준 Gemma 4 31B는 20.9 tokens/s, Qwen 2.5 32B는 21.0 tokens/s를 기록했습니다. 반면, MoE 구조를 가진 Gemma 4 26B는 V100 2개(Q8)만으로도 70 tokens/s의 장벽을 돌파했습니다.
- 양자화(Quantization) 수준에 따른 변화: 만약 Q4(4-bit quantization)로 낮추어 구동한다면, V100 2개를 사용하여 128K에서 4K 사이의 컨텍스트 범위 내에서 Qwen 3.6 35B를 77.1에서 105.4 tokens/s라는 경이로운 속도로 구동할 수 있습니다.
- P100 GPU와의 세대 차이: 비교군인 P100의 경우, 동일한 컨텍스트 범위에서 Q8 Qwen 3.6 35B 모델에 대해 40.2~5CA.2 tokens/s 수준에 그쳤으며, 70 tokens/s 목표를 달성한 것은 오직 Qwen 2.5 3B 모델뿐이었습니다.
- 최신 고가 하드웨어와의 경쟁력: MSRP $4,700인 Nvidia DGX Spark나, 40코어 GPU, 128GB 메모리, 1TB SSD를 탑재하여 $2,499(기본)에서 $5,399(테스트 사양)에 달하는 M5 Max Mac Studio와 비교해도, 이 3x V100 빌드는 수집된 데이터상으로 충분히 경쟁력 있는 성능을 보여주었습니다.
여기서 우리가 주목해야 할 중요한 기술적 통찰이 하나 있습니다. 많은 사용자가 GPU 카드를 추가하면 성능이 비례해서 올라갈 것이라 기대하지만, 실제로는 "카드를 추가하면 메모리 용량은 늘어나지만, 생성 속도(speed) 자체가 직접적으로 빨라지는 것은 아니다"라는 점입니다. 추가된 카드는 더 큰 모델을 올릴 수 있는 '그릇'을 키워주는 역할을 할 뿐, 연산의 물리적 속도 한계를 결정짓는 것은 아닙니다.
결론적으로, 이번 벤치마크는 구형 'e-waste'라 불리는 GPU들이 MoE라는 현대적 모델 구조와 만났을 때 얼마나 강력한 퍼포먼스를 낼 수 있는지를 증명했습니다. 비록 냉각을 위해 3D 프린팅된 부품을 직접 제작해야 하는 번거로움이 따르더라도, 저렴한 비용으로 최신 LLM의 초고속 추론 환경을 구축하고자 하는 홈랩 사용자들에게 V100은 여전히 매력적인 선택지임이 분명합니다.
3부: 중고 GPU 스케일링의 명암: 메모리 확장성 및 에너지 효율성 분석#
이번 실험에서 가장 흥미로운 지점은 최신 하드웨어와의 성능 격차를 정밀하게 분석한 대목입니다. 우선 Apple의 하드웨어와 비교해 보겠습니다. oMLX 벤치마크 페이지에 기록된 40개의 GPU 코어와 128GB의 통합 메모리를 탑재한 M5 Max의 데이터를 살펴보면, Qwen 3.6 35B 모델에서 약 195K-token의 프롬프트를 처리할 때 초당 43.9토큰(tokens per second)이라는 수치를 보여줍니다. 컨텍스트 길이에 따라 승패가 갈리는데, 4K 및 32K 구간에서는 Mac이 소폭 앞서 나가는 모습을 보였지만, 64K와 128K의 긴 컨텍스트 구간에 진입하면 중고 V100 시스템이 다시 역전하며, 가장 긴 컨텍스트에서는 무려 19%나 앞선 성능을 기록했습니다. 다만, 각 기기가 서로 다른 런타임(runtime)을 사용하고 있다는 점을 고려하여 이 수치를 해석할 때는 주의가 필요합니다.
비교 대상은 여기서 끝이 아닙니다. Kleybrink의
dgx-src-bench 데이터를 보면, Ollama를 'thinking mode'로 실행하여 짧은 프롬프트를 처리했을 때의 성능은 초당 45.8토큰에 그쳤습니다. 이는 앞서 언급한 V100 시스템이 4K 컨텍스트에서 보여준 성능의 절반에도 미치지 못하는 수치입니다. 물론, 제작자 스스로도 인정하듯 최신 GPU들은 "퇴역한 구형 모델들을 압도적으로 파괴(destroy)"하는 수준입니다. 인퍼런스 제공업체인 Parasail이 전용 H100 및 B200 배포 환경을 통해 후원한 비교 데이터에 따르면, 128K 컨텍스트에서 두 개의 H100은 약 315 tokens/s를, 단 한 개의 B200은 약 455 tokens/s라는 경이로운 속도를 보여주었습니다. 특히 B200은 V100 시스템보다 약 6배나 빠른 성능을 자랑하는데, 주목할 점은 최신 GPU들은 16-bit 풀 모델을 구동한 반면, V100 시스템은 8-bit 양자화 모델을 사용했다는 사실입니다.에너지 효율성 측면에서도 중고 GPU의 가치는 재발견되었습니다. 128K 컨텍스트에서 35B 모델을 실행했을 때, V100 세팅은 약 0.02 kWh의 전력을 소모하는 데 그쳤습니다. 이는 P100을 사용했을 때보다 두 배나 적은 수치이며, 두 개 혹은 세 개의 K80 GPU를 사용할 경우 0.35에서 0.45 kWh까지 치솟는 것과 비교하면 압도적인 저전력 효율을 보여줍니다. 결과적으로 V100-16GB 모델은 P100과 비교했을 때 "더 적은 에너지를 소비하면서도 더 높은 점수를 기록(puts up better scores while consuming less energy)"하는 놀라운 효율성을 입증했습니다. 단, 이 수치는 벽면 콘센트(wall) 기준이 아닌 GPU 자체의 소비 전력을 의미한다는 점을 유념해야 합니다.
앞으로의 로드맵 또한 기대감을 모으고 있습니다. 제작자는 단순한 속도 경쟁을 넘어, 모델이 24시간 내내 끊임로 프롬프트를 처리하는 이른바 '소프트웨어 팩토리(software factory)' 성능에 부합하는 벤치마크를 구축하고자 합니다. 이 환경에서는 순간적인 속도보다 지속적인 처리 능력이 더 중요하기 때문입니다. 또한, 현재 출시 준비가 거의 완료된 상태인 새로운 쿨러(cooler)에 대해서도 언급하며, 메일링 리스트를 통해 베타 테스터를 모집할 계획임을 밝혔습니다(구체적인 출시일은 미정입니다). 아울러 Reddit 스레드를 통해, 향후 인퍼런스 백엔드를 비교하고 성능 향상을 위해 '추측적 디코딩(speculative decoding)' 기술을 적용하겠다는 야심 찬 계획도 덧붙였습니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 중고 V100 시스템 (8-bit) | 최신 GPU (H100/B200, 16-bit) | Apple M5 Max (Unified Memory) | 핵심 차이점 |
|---|---|---|---|---|
| 긴 컨텍스트 성능 (128K) | 우수 (Long Context 우위) | 압도적 (B200 기준 455 t/s) | 상대적 열세 (단, 4K/32K는 우위) | V100이 긴 컨텍스트에서 19% 앞섬 |
| 에너지 효율 (128K 실행 시) | 약 0.02 kWh (매우 효율적) | 측정 불가 (고성능/고전력) | 측정 불가 | V100이 P100 대비 2배 효율적 |
| 연산 정밀도 (Precision) | 8-bit 양자화 적용 | 16-bit Full Precision | 128GB 통합 메모리 기반 | 최신 GPU는 높은 정밀도에서 압도적 |
| 처리 속도 (Short Prompt) | 약 100+ tokens/s (추정) | H100(315 t/s), B200(455 t/s) | 약 43.9 tokens/s (195K 프롬프트 시) | 최신 하드웨어가 초당 토큰 수 압도적 |
독자 체크리스트 및 자주 묻mathcal 묻는 질문 (FAQ)#
🚀 중고 GPU 홈랩 구축을 위한 체크리스트
- [ ] VRAM 용량 확인: 긴 컨텍스트(64K 이상) 처리를 위해 충분한 GPU 메모리가 확보되었는가?
- [ ] 양자화 전략 수립: 8-bit 양자화를 통해 메모리 효율과 성능 사이의 균형을 맞추었는가?
- [ ] 전력 공급 및 냉각 대책: GPU 자체 소비 전력 외에 전체 시스템의 전력량과 쿨링 솔루션(신규 쿨러 등)이 준비되었는가?
❓ 자주 묻는 질문 (FAQ)
Q1. 왜 V100 시스템이 M5 Max보다 긴 컨텍스트(128K)에서 더 빠른 성능을 내나요? A1. 벤치마크 결과에 따르면, 4K나 32K 같은 짧은 컨텍스트에서는 Mac의 성능이 소폭 앞서지만, 64K 이상의 긴 컨텍스트로 넘어가면 V100 시스템이 약 19% 더 높은 성능을 기록합니다. 이는 GPU의 메모리 대역폭 및 아키텍처 특성이 긴 문맥 처리 시점에 따라 다르게 작용하기 때문이며, 다만 서로 다른 런타임을 사용했다는 변수가 존재합니다.
Q2. 향후 이 프로젝트에서 기대할 수 있는 기술적 진보는 무엇인가요? A2. 제작자는 지속적인 프롬프트 요청이 발생하는 '소프트웨어 팩토리' 환경에 최적화된 벤치마크를 준비 중입니다. 또한, 성능을 극대화하기 위해 '추측적 디코딩(speculative decoding)' 기술을 도입하고 다양한 인퍼런스 백엔드를 비교 분석할 예정이며, 곧 출시될 새로운 전용 쿨러를 통해 하드웨어 안정성도 높일 계획입니다.
딥러너 (DeepLearner)이었습니다.
🔗 원문 참고 및 출처: Three 'e-waste' Nvidia V100s hit 100 tokens per second on Qwen 3.6 35B in a $1,042 homelab rig


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성