
⚡ 결론 직답: OpenAI가 미공개 AI 모델을 활용해 AMD 차세대 GPU의 PPA를 14% 개선했으며, 1년 분량의 칩 설계 작업을 5개월 미만으로 단축하는 성과를 거두었습니다.
📌 3줄 핵심 요약
- OpenAI의 AI 모델이 AMD의 차세대 GPU 회로 설계를 최적화하여 PPA(전력·성능·면적)를 최대 14% 개선하고 CPU 설계 효율도 높임
- SystemVerilog RTL 코드 재작성을 통해 1년 소요될 설계 공정을 5개월 미만으로 단축했으며, GPT-6.2 Astra 모델이 최적화 테스트에서 최고 성능을 기록함
- Broadcom과 협력 중인 'OpenAI Jalapeño' 칩은 2026년 말 배포 예정이며, NVIDIA Blackwell 대비 우수한 전력 효율과 저지연 성능을 목표로 함
📅 데이터 기준일: 2026-11-20 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
반도체 설계의 패러다임이 근본적으로 뒤바뀌고 있습니다. 단순히 인공지능을 활용하는 수준을 넘어, 이제는 인공지능이 직접 반도체의 설계도를 수정하고 최적화하는 시대가 도래한 것입니다. 최근 공개된 OpenAI와 AMD의 협력 사례는 이러한 변화를 상징적으로 보여주는 아주 중요한 이정표가 될 것으로 보입니다.
1부: OpenAI와 AMD의 파트너십, AI를 통한 차세대 GPU·CPU 설계 혁신#
최근 OpenAI는 글로벌 반도체 기업 AMD와의 지속적인 파트너십에 대한 새로운 세부 정보를 공개했습니다. 이번 협력의 핵심은 OpenAI가 보유한, 아직 구체적인 명칭이 밝혀지지 않은 '비공라(undisclosed) AI 모델'을 활용하여 AMD의 차세대 플래그십 GPU 및 CPU 설계를 최적화하는 데 있습니다. 그 결과는 놀라울 정도로 구체적입니다. GPU 회로 설계 분야에서는 최대 14%에 달하는 PPA(Power, Performance, and Area; 전력, 성능, 면적) 개선을 달성했으며, CPU 설계에서도 한 자릿수 퍼센트(single-digit) 수준의 PPA 이득을 거두는 성과를 냈습니다. 반도체 설계에서 PPA의 개선은 곧 칩의 경쟁력과 직결되는 만큼, 이는 하드웨어 제조사인 AMD에 엄청난 기술적 우위를 제공할 것으로 보입니다.
이러한 혁신적인 성과를 가능하게 한 기술적 메커니즘은 매우 정교합니다. OpenAI 측의 설명에 따르면, 자사의 AI 모델은 칩의 회로를 기술하는 코드를 직접 재작성(rewriting)함으로써 추가적인 성능 향상을 포착해냈습니다. 이때 사용된 언어는 고성능 반도체 설계의 표준이라 할 수 있는 'SystemVerilog RTL(Register Transfer Level)'입니다. 이는 단순히 텍스트를 생성하는 수준을 넘어, 하드웨어의 논리 구조를 이해하고 수정할 수 있는 능력을 갖추었음을 의미합니다. 더욱 놀라운 점은 작업의 효율성입니다. OpenAI는 이번 최적화 노력이 기존의 전통적인 방식으로는 무려 1년이 소요되었을 법한 방대한 설계 작업을 단 '5개월 미만(under 5 months)'으로 압축하는 효과를 냈다고 주장했습니다. 이는 반도체 설계 분야에서는 전례를 찾아보기 힘든(unprecedented) 엄청난 속도의 혁신입니다.
더 나아가, 이번 프로젝트에서 보여준 AI의 논리적 사고 능력은 경이로운 수준에 도달해 있습니다. OpenAI는 자사의 모델이 RTL 설계 과정에서 마치 '전문 마이크로아키텍트(expert microarchitect)'와 같은 수준으로 추론(reasoning)을 수행했다고 밝혔습니다. 즉, 단순한 패턴 인식을 넘어 칩의 구조적 아키텍처를 깊이 있게 이해하고 논리적 판단을 내렸다는 뜻입니다. 또한, OpenAI는 현재의 개선된 베이스라인(baseline)을 바탕으로, 향후 진행될 GPU와 CPU 설계 작업에서도 더욱 높은 수준의 PPA 개선을 이끌어낼 수 있을 것으로 기대하고 있습니다. 이는 AI가 설계의 보조 도구를 넘어, 설계의 핵심 주체로 자리 잡고 있음을 시사합니다.
사실 OpenAI가 반도체 설계 영역에서 두각을 나타낸 것은 이번이 처음이 아닙니다. OpenAI는 이미 Broadcom(브로드컴)과 협력하여 추론 전용 칩(inference-targeted chip)인 'OpenAI Jalapeño'를 설계하는 프로젝트를 진행한 바 있습니다. 이 프로젝트를 통해 개발된 칩은 이미 2026년 6월(as far back as June 2026)부터 엔지니어링 샘플을 통해 실제 워크로드를 구동하며 그 성능을 입증해 왔습니다. 이처럼 OpenAI는 단순한 소프트웨어 기업을 넘어, 자신들의 AI 모델을 최적으로 구동할 수 있는 맞춤형 하드웨어 생태계를 구축하기 위해 하드웨어 설계의 근간을 흔드는 혁신을 지속적으로 이어가고 있습니다.
2부: SystemVerilog RTL 최적화와 1년치 설계를 5개월로 단축한 AI의 성능#
OpenAI와 AMD의 이번 협업은 단순히 설계 기간을 단축하는 것을 넘어, 차세대 반도체 시장의 판도를 바꿀 수 있는 구체적인 실행 계획을 포함하고 있습니다. 특히 Broadcom과 함께 개발 중인 추론 특화 칩인 'Jalapeño'의 향후 로드맵은 업계의 이목을 집중시키고 있습니다. OpenAI의 계획에 따르면, Jalapeño는 2026년 말경 소규모 초기 배포를 시작으로, 2027년에는 더욱 광범위한 시장 출시를 목표로 하고 있습니다. 이미 공개된 테스트 벤치마크 결과에 따르면, 이 칩은 single-token prediction 워크로드 환경에서 현재 시장의 리더인 Nvidia Blackwell GPU와 비교했을 때, 전력 소모량과 전체적인 지연 시간(latency) 측면에서 매우 탁월한 절감 효과를 보여줄 것으로 기대되고 있습니다.
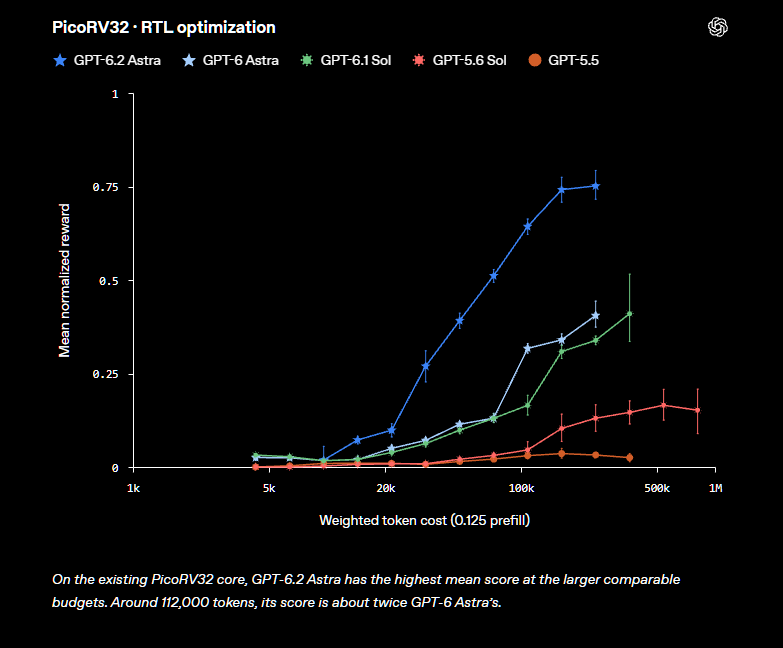
이러한 기술적 도약의 핵심은 OpenAI의 고도화된 LLM이 단순한 텍스트 생성을 넘어, 실제 하드웨어의 구조적 설계를 개선하는 '설계 지능'을 갖추었음을 증명하는 데 있습니다. OpenAI 연구진은 GPT 모델의 칩 설계 능력을 검증하기 위해 매우 정교한 실험을 설계했습니다. 연구팀은 고성능 LLM들에게 PicoRV32 및 Ibex와 같은 기존의 칩 코어를 개선하라는 과제를 부여했습니다. 실험 과정에서 각 모델은 실행당 무려 112,000 토큰에 달하는 방대한 데이터를 입력받았으며, 모델의 목표는 명확했습니다. 바로 throughput(즉, Instructions-per-Clock과 clock cycle duration의 결합 지표)을 최적화하는 것이었습니다.
이번 실험의 기술적 세부 사항과 성과를 정리하면 다음과 같습니다.
- Jalapeño 배포 로드맵: 2026년 말 초기 소규모 배포를 시작으로, 2027년에 본격적인 대규모 출시를 예정하고 있습니다.
- Nvidia Blackwell 대비 경쟁력: single-token prediction 워크로드 기준, Nvidia Blackwell GPU 대비 전력 소모 및 전체 지연 시간(latency)의 획기적인 절감을 입증했습니다.
- 설계 최적화 목표(Throughput): 모델은 Instructions-per-Clock(IPC)과 clock cycle duration을 결합한 지표인 throughput을 극대화하도록 훈련되었습니다.
- 엄격한 평가 스코어링 시스템: 설계된 칩이 제대로 작동하지 않거나, 기존 면적의 16배를 초과하는 설계를 내놓을 경우 즉시 0점(fat zero)을 부여했으며, 제약 조건 내 최적의 설계에만 1.0점을 부여하는 엄격한 기준을 적용했습니다.
- GPT-6.2 Astra의 압도적 성과: 실험 결과, GPT-6.2 Astra 모델이 가장 낮은 비용과 가장 높은 최적화 점수를 동시에 기록하며, 두 가지 축 모두에서 압도적인 성능을 보여주었습니다.
주목해야 할 점은 이 실험이 모델에게 매우 불리한 조건, 즉 '블라인드 테스트' 형태로 진행되었다는 사실입니다. OpenAI 연구진은 모델들에게 해당 칩이 구체적으로 어떤 워크로드에 사용될 것인지에 대한 정보를 전혀 제공하지 않았습니다. 즉, 모델은 자신이 설계하는 하드웨어가 어떤 환경에서 구동될지 모르는 상태에서 오로지 구조적 최적화에만 집중해야 했던 것입니다. 이러한 극한의 제약 속에서도 GPT-6.2 Astra가 보여준 성과는 AI가 단순한 보조 도구를 넘어, 전문적인 마이크로아키텍트의 영역까지 침투할 수 있음을 시사합니다.
결국 이번 성과는 AI가 SystemVerilog RTL 코드를 재작성함으로써 하드웨어의 물리적 특성을 근본적으로 개선할 수 있음을 보여줍니다. 1년이 걸릴 법한 방대한 설계 작업을 단 5개월 미만으로 압축해낸 이 기술은, 앞으로 AI 기반의 자동화된 설계(EDA)가 반도체 산업의 개발 주기와 비용 구조를 어떻게 혁신적으로 재편할지를 보여주는 중요한 이정표가 될 것입니다.
3부: GPT-6.2 Astra의 검증 결과와 차세대 추론용 칩 'Jalapeño'의 전망#
이번 연구에서 진행된 두 번째 테스트 결과는 매우 흥미로우면서도, 한편으로는 반도체 설계 전문가들에게는 어느 정도 예상 가능한 사실을 드러냈습니다. 연구 결과에 따르면, AI 모델들은 기존에 작성된 코드를 단순히 수정하거나 최적화(optimizing existing code)하는 작업보다, 칩의 초기 사양(initial specifications)에 맞춰 칩을 사실상 처음부터 다시 설계(redesigning)할 때 훨씬 더 뛰어난 결과물을 산출해냈습니다. 이는 AI가 단순한 '수리공'의 역할을 넘어, 설계의 근본적인 구조를 재정의하는 '아키텍트'로서의 잠재력을 가지고 있음을 입증하는 대목입니다.
다만, 이번 성과를 달성하기 위해 OpenAI의 과학자들이 수정되지 않은(unmodified) 버전의 GPT 모델을 그대로 사용했는지에 대해서는 아직 명확한 정보가 공개되지 않았습니다. 현재 기술 시장에는 막대한 비용을 감당할 수 있는 기업들을 위해 특정 작업에 특화된 고성능 LLM(Task-specific high-end LLMs)들이 이미 존재하고 있기 때문입니다. 따라서 이번 실험 결과가 범용 모델의 순수한 추론 능력인지, 아니면 칩 설계 데이터로 정교하게 튜닝된 특화 모델의 결과인지는 향후 추가적인 분석이 필요한 부분입니다.
그럼에도 불구하고 OpenAI의 미래 로드맵은 매우 구체적이며 공격적입니다. OpenAI는 현재 반도체 설계 자동화(EDA) 분야의 글로벌 리더인 Synopsys와 협력하여, 칩 설계 도구를 능숙하게 다룰 수 있는 전용 모델인 'GPT-Synopsis'를 훈련시키고 있다고 밝혔습니다. 이는 AI가 단순히 설계안을 제안하는 수준을 넘어, 실제 엔지니어들이 사용하는 전문 설계 툴을 직접 제어하고 운용하는 시대를 준비하고 있음을 의미합니다.
이러한 기술적 진보는 OpenAI가 추진 중인 차세대 추론용 칩인 'Jalapeño'의 성공 가능성을 더욱 높여주고 있습니다. 이미 2026년 6월까지는 엔지니어링 샘플이 실제 워크로드를 구동하는 단계에 도달할 것으로 보이며, 2026년 말에는 소규모 초기 배포(small initial deployments)를, 2027년에는 본격적인 광범적 배포(broader rollout)를 목표로 하고 있습니다. 특히 Jalapeño는 단일 토큰 예측 워크로드에서 시장의 선두주자인 Nvidia의 Blackwell GPU와 비교했을 때, 전력 소모와 전체적인 지연 시간(latency) 측면에서 압도적인 절감 효과를 보여줄 것으로 기대되고 있습니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 기존 방식 (Conventional) | 신규 AI 기반 방식 (AI-Driven) | 핵심 차이점 |
|---|---|---|---|
| 설계 접근법 | 기존 코드 및 RTL 최적화 중심 | 초기 사양 기반 칩 재설계(Redesign) | 단순 수정을 넘어선 구조적 혁신 |
| 설계 소요 시간 | 약 1년 (12개월) 소요 | 5개월 미만으로 단축 | 설계 주기 약 50% 이상 단축 |
| 모델 활용 범위 | 범용 LLM의 제한적 활용 | GPT-Synopsis 등 설계 특화 모델 | EDA 도구와의 직접적인 연동 및 제어 |
| 성능 목표 (PPA) | 기존 설계 기준 성능 유지 | 14% 이상의 PPA 개선 달성 | 전력, 면적, 성능의 극대화된 최적화 |
| 주요 비교 대상 | 기존 GPU 아키텍처 기준 | Nvidia Blackwell GPU 대비 우위 | 전력 및 지연 시간의 획기적 절감 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
💡 반도체 AI 설계 트렌드 체크리스트
- [ ] AI가 기존 코드를 수정하는 수준을 넘어, 초기 사양을 바탕으로 재설계(Redesign)를 수행하고 있는가?
- [ ] 칩 설계 도구(EDA)와 연동된 작업 특화형 모델(예: GPT-Synopsis)의 도입이 준비되었는가?
- [ ] 차세대 추론용 칩(예: Jalapeño)의 배포 일정(2026년 샘플, 2027년 본격 배포)을 숙지하고 있는가?
❓ 자주 묻는 질문 (FAQ)
Q1. 이번 실험에 사용된 GPT 모델은 일반적인 모델인가요, 아니면 특수 모델인가요? A1. 현재까지는 연구진이 수정되지 않은(unmodified) 버전의 GPT를 사용했는지에 대해 명확히 밝히지 않았습니다. 다만, 고비용을 지불할 수 있는 사용자를 위한 작업 특화형 고성능 LLM이 존재하며, OpenAI는 Synopsys와 함께 칩 설계 도구 활용에 특화된 'GPT-Synopsis'를 개발 중입니다.
Q2. OpenAI의 'Jalapeño' 칩이 기존 Nvidia Blackwell GPU보다 우수하다고 판단할 근거는 무엇인가요? A2. 공개된 벤치마크 테스트에 따르면, Jalapeño는 단일 토큰 예측(single-token prediction) 워크로드에서 Nvidia Blackwell GPU와 비교했을 때 전력 소모(power draw)와 전체적인 지연 시간(latency) 측면에서 매우 뛰어난 절감 효과를 보여줄 것으로 나타났습니다.
앞으로 AI가 반도체 설계의 패러다임을 어떻게 바꿔나갈지, 딥러너 (DeepLearner)가 계속해서 밀착 취재하겠습니다.
딥러너 (DeepLearner)이었습니다.


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성