
⚡ 결론 직답: 한 변호사가 9,450달러 규모의 중고 Nvidia V100 12개를 활용해 DeepSeek V4.1 Flash의 15,360개 전문가를 4-bit NVFP4로 구동하는 개인용 AI 서버를 구축했습니다.
📌 3줄 핵심 요약
- DeepSeek V4.1 Flash의 15,360개 모든 전문가를 4-bit NVFP4 정밀도로 12개의 V100 GPU에 온보딩 성공
- 코드 생성 시 초당 최대 184 토큰을 기록하며, 3대의 DGX Spark 대비 절반 가격으로 더 빠른 디코딩 성능 구현
- V100의 하드웨어 한계를 소프트웨어 언패킹 기술로 극복하며 구형 GPU를 활용한 저비용 고성능 AI 서버 모델 제시
📅 데이터 기준일: 2026-11-20 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
1부: 9,450달러의 투자, 중고 V100 12개로 완성한 DeepSeek V4.1 Flash 서버#
최근 AI 커뮤니티에서는 개인용 AI 서버의 한계를 돌파한 한 변호사의 놀라운 실험 결과가 큰 화제를 모으고 있습니다. Reddit의 r/LocalLLM 커뮤니티를 통해 알려진 이 사례의 주인공인 Nick Mermiges는 자신의 개인용 AI 서버를 한 단계 더 업그레이드하며, 기존 8개였던 중고 Nvidia V100 GPU를 총 12개로 증설하는 과감한 투자를 단행했습니다. 총 9,450달러(한화 약 1,300만 원 상당)가 투입된 이번 업그레이드의 핵심은 DeepSeek V4.1 Flash 모델의 모든 전문가(Expert) 레이어를 4-bit NVFP4 정밀도로 구동할 수 있는 환경을 구축했다는 점입니다.
이번 업그레이드를 통해 구현된 성능 수치는 가히 압도적입니다. 코드 생성 작업 시 초당 최대 184토큰(tokens per second)에 달하는 속도를 기록했으며, 긴 문서를 처리할 때도 이전보다 약 절반의 시간 만에 답변을 내놓는 놀라운 효율성을 보여주었습니다. 특히 주목할 점은 이 개인용 서버의 가성비입니다. Nick Mermiges는 자신의 서버가 단일 요청을 디코딩하는 속도 면에서 공개된 DGX Spark 스택(4개 구성 기준)보다 빠를 수 있다고 밝혔습니다. 더욱 놀라운 것은 3대의 DGX Spark를 운용할 때 드는 비용의 절반 수준인 9,450달러만으로도 그에 상응하거나 그 이상의 성능을 구현해냈다는 사실입니다. 또한, 128K 크기의 파일을 읽어들이는 데 단 28초밖에 걸리지 않는 놀라운 처리 능력을 입증했습니다.
Nick Mermiges의 이번 행보는 마치 전설적인 영화 시리즈가 '3'이라는 숫자를 통해 완성되듯, 철저히 계산된 확장 과정을 거쳐왔습니다. 그는 이미 이전 단계에서 메모리 증설 및 기타 최적화 작업을 통해 서버를 개선한 바 있으며, 이번에는 V100 GPU를 탑재한 세 번째 보드를 추가함으로써 총 12개의 GPU(보드당 4개씩 구성)를 갖춘 시스템을 완성했습니다. 언뜻 보기에는 과도한 GPU 투자처럼 보일 수 있는 이 '광기 어린' 실험에는, 모델의 정밀도를 최대한 확보하려는 명확한 기술적 의도가 담겨 있습니다.
기술적인 관점에서 볼 때, 이번 업그레이드는 메모리 부족 문제를 해결하기 위한 필연적인 선택이었습니다. 기존의 32GB 용량을 가진 8개의 V100 카드는 총 254 GiB의 VRAM을 제공했지만, Nvidia의 NVFP4 기술을 적용하여 DeepSeek V4.1 Flash 모델의 전문가들을 제대로 구동하기 위해서는 278.9 GiB라는 더 큰 메모리 공간이 필요했기 때문입니다. 이전까지 그는 메모리 한계를 극복하기 위해 모든 전문가를 2-bit 정밀도로 압축하여 구동하고, 가장 빈번하게 사용되는 5,949개(전체의 약 38.7%)의 전문가 레이어만을 NVFP4로 전환하여 카드가 가득 찰 때까지 스와핑(swapping)하는 고육지책을 사용해야만 했습니다.
하지만 이제 12개의 V100으로 확장된 새로운 서버에서는 DeepSeek V4.1 Flash가 보유한 15,360개의 모든 전문가 레이어를 압축 없이 온전한 상태로 구동할 수 있게 되었습니다. 그의 GitHub 저장소(repo)에 따르면, 이번 설정에서는 "더 이상의 추가 압축은 없다(none compressed further)"고 명시되어 있습니다. 그는 자신의 웹사이트에 게재된 상세 기술 리포트에서도, 모델의 일부 다른 부분들이 압축된 형태를 취하고 있기는 하지만, 핵심적인 전문가 레이어의 값(expert values)만큼은 DeepSeek의 공식 릴리스 버전과 동일한 수준을 유지하고 있다고 강조했습니다. 이는 개인용 서버에서도 상용 모델에 근접한 정밀도를 구현할 수 있음을 시사하는 매우 의미 있는 성과라고 할 수 있습니다.
2부: 4-bit NVFP4 구현을 위한 GPU 확장 및 정밀도 최적화 메커니즘 분석#
이번 프로젝트에서 가장 눈여겨봐야 할 대목은 2018년에 출시된 구형 GPU인 Nvidia V100이 어떻게 최신 Blackwell 시대의 핵심 포맷인 NVFP4를 구동할 수 있느냐는 점입니다. 기술적인 관점에서 보면 V100에는 FP4나 FP8을 처리할 수 있는 전용 tensor cores가 존재하지 않습니다. 따라서 모든 NVFP4 데이터는 연산에 앞서 소프트웨어적으로 먼저 half precision(반정밀도) 형태로 언패킹(unpack)되는 과정을 거쳐야만 합니다. 하지만 놀랍게도 이러한 방식은 여전히 유효한 전략입니다. 그 이유는 압축된 전문가(experts) 데이터 덕분에 GPU 카드가 읽어들여야 하는 데이터의 총 바이트 수가 줄어들기 때문입니다. 즉, 연산 속도 자체가 빨라지는 것이 아니라, 데이터 전송 효율이 극대화되면서 2018년의 하드웨어가 최신 세대의 데이터 포맷을 감당할 수 있게 되는 것입니다.
이 거대한 모델을 구동하기 위해 서버의 아키텍처는 매우 정교하게 설계되었습니다. 모델의 레이어들은 각 보드에 나누어 할당되었는데, 구체적으로는 0–13, 14–27, 그리고 28–39 레이어 구간으로 분할되어 관리됩니다. 각 보드에 장착된 4개의 카드는 Nvidia의 초고속 인터커넥트 기술인 NVLink를 통해 긴밀하게 연결되어 데이터를 공유합니다. 하지만 보드와 보드 사이의 데이터 전송은 조금 더 복잡한 경로를 거칩니다. 보드 간의 핸드오프(hand-off)는 호스트의 PCIe를 거치게 되는데, 이때 두 개의 별도 PCIe switches가 관여합니다.
- 데이터 전송 및 스위치 구조: 첫 번째와 두 번째 보드는 PEX88096 스위치를 공유하므로 보드 간 통신이 스위치 내부에서 효율적으로 이루어집니다. 반면, 세 번째 보드는 별도의 PLX 8749 스위치 뒤에 배치되어 있어, 두 번째 핸드오프 과정에서 호스트의 PCIe bridges를 반드시 통과해야 하며 이 과정에서 필연적인 지연 시간(latency)이 발생합니다.
- 전력 및 클럭 최적화(Power & Clock Tuning): 성능과 정밀도의 균형을 맞추기 위해 각 카드의 설정값을 조정했습니다. 구체적으로 각 카드의 power cap을 기존 150 W에서 175 W로 상향 조정한 반면, clock cap은 1,522 MHz에서 1,452 MHz로 낮추어 안정적인 고성능을 유도했습니다.
- 프롬프트 처리 성능(Prompt Reading): 32K 컨텍스트를 넘어선 시점에서의 프롬프트 읽기 속도는 초당 약 4,500 tokens에 달합니다. 이는 초기 빌드에서 기록했던 초당 약 2,200 tokens와 비교했을 때 두 배 이상의 비약적인 향상을 보여줍니다.
- 코드 디코딩 효율(Code Decode): 1K 토큰 규모에서의 코드 디코딩 속도는 이전보다 23% 빨라졌습니다. 다만, 32K 이상의 긴 컨텍스트 구간에서는 눈에 띄는 성능 이득이 관찰되지 않았는데, 이는 주로 첫 번째 토큰이 생성될 때까지의 대기 시간이 단축된 것에 주된 원인이 있습니다.
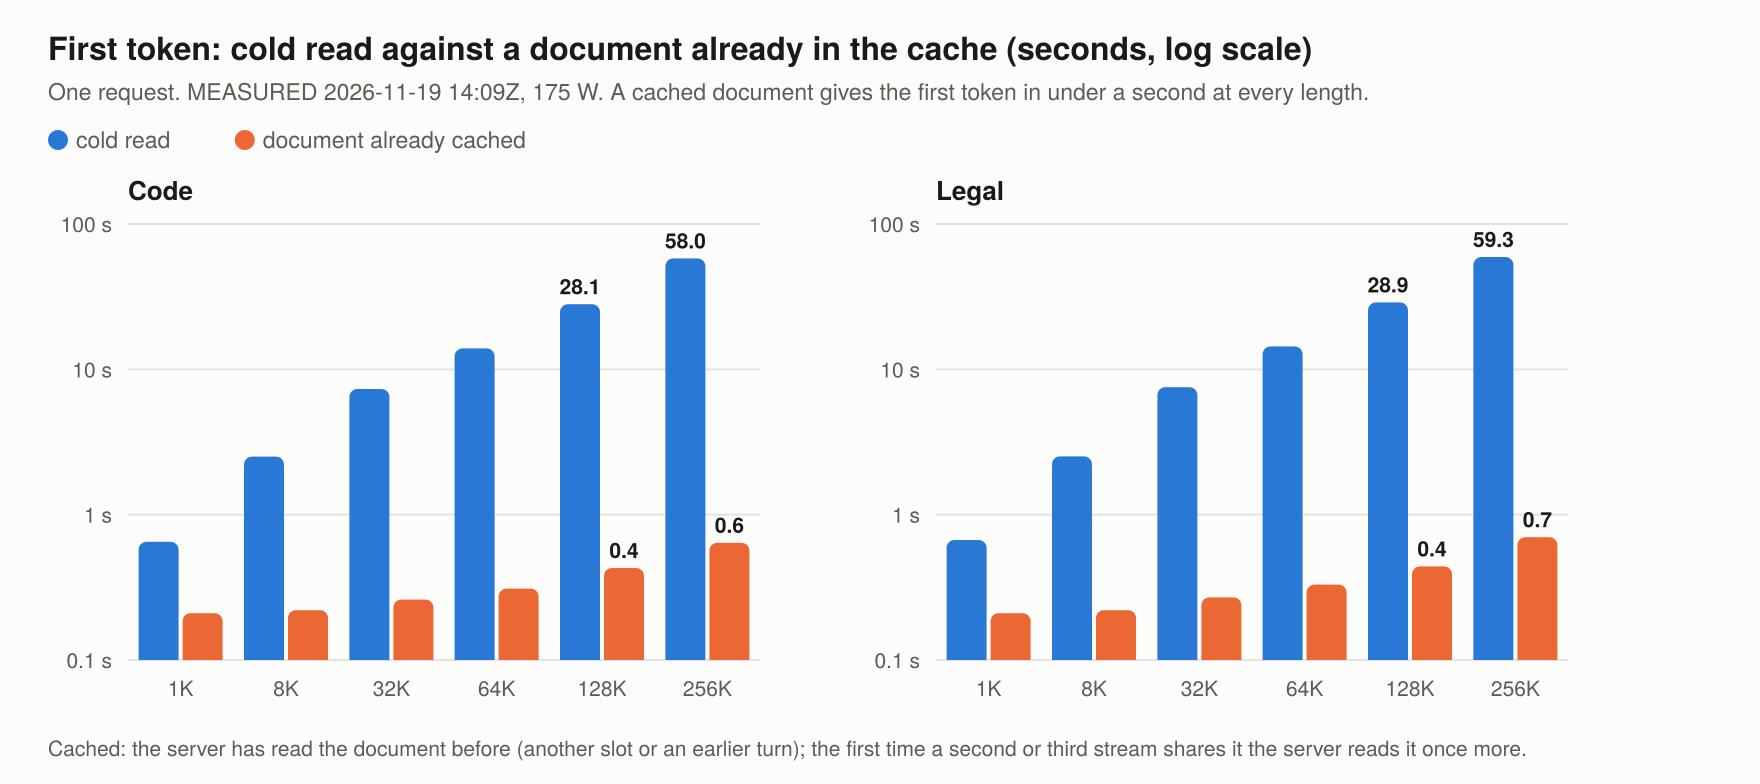
이러한 복잡한 하드웨어적 한계와 레이턴시 문제를 극복하기 위한 시도는 수치로 증명되었습니다. 측정 결과에 따르면, 256K 컨텍스트 환경에서 첫 번째 코드 토큰이 생성되는 데 걸리는 시간은 58초를 기록했습니다. 이는 이전 업그레이드 단계에서 기록했던 108.4초와 비교하면 거의 두 배 가까이 단축된 놀라운 수치입니다. 물론 이러한 성능 향상의 일부는 power cap을 높인 설정의 영향도 있겠지만, 구조적인 최적화가 뒷받침되었기에 가능한 결과였습니다.
결론적으로, 이번 시스템의 진정한 가치는 단순히 연산 속도를 높인 것에 있지 않습니다. PLX 8749 스위치로 인한 지연 시간이라는 물리적 제약을 극복하고, 소프트웨어적 언패킹을 통해 NVFP4의 이점을 극대화함으로써, 구형 하드웨어에서도 최신 모델의 압축된 전문가들을 효율적으로 구동할 수 있음을 보여주었다는 데 큰 의미가 있습니다. 비록 32K 이상의 대규모 컨텍스처에서는 디코딩 속도 자체의 드라마틱한 상승은 없었으나, 사용자 입장에서 가장 체감되는 '첫 토큰 대기 시간'을 획기적으로 줄였다는 점은 개인용 AI 서버 구축에 있어 매우 중요한 이정표가 될 것입니다.
3부: 구형 하드웨어의 한계를 넘는 소프트웨어 기법과 DGX Spark 대비 압도적 가성비#
하드웨어의 잠재력을 극한으로 끌어올리려는 시도는 때로 예상치 못한 물리적 한계에 부딪히기도 합니다. 이번 프로젝트의 설계자는 각 V100 카드의 전력 제한(Power Cap)을 기존 150W 또는 175W 수준에서 200W까지 높여 시스템 성능을 극대화하고자 하루 동안 테스트를 진행했습니다. 하지만 결과는 그리 낙관적이지 않았습니다. "네 개의 긴 채팅이 동시에 진행될 때 호스트가 한 차례 차단(tripped)되었다"는 기록은, 과도한 전력 소모가 시스템 전체의 안정성을 위협할 수 있음을 보여줍니다. 이는 전력 공급 장치의 임계치를 넘어서는 부하가 발생했음을 의미합니다.
성능 최적화를 위해 적용하려 했던 소프트웨어적 기법들도 순탄치만은 않았습니다. 설계자는 시스템의 효율을 높이기 위해 네 가지 핵심 최적화 전략을 구상했습니다. 디스크에 대화 내용을 저장하는 'conversation store', 섹션 간의 데이터 전송을 가볍게 만드는 'leaner hand-off', 더욱 정밀한 전문가 패킹 기술인 'tighter expert packing', 그리고 4개의 카드가 연산에 정확히 참여하도록 하는 'exact four-card-sum arithmetic'이 그 주인공입니다. 그러나 안타깝게도 이 기법들은 각각 설정했던 목표치(targets)를 달성하지 못했고, 결국 현재는 모두 비활성화된 상태로 운영되고 있습니다.
물론 다중 요청을 통해 처리량을 높이는 방식은 어느 정도 유효한 성과를 거두었습니다. 128K 컨텍스트 환경에서 세 개의 요청을 동시에 처리했을 때, 코드(code) 데이터에서는 초당 약 360 토큰, 법률(legal) 데이터에서는 초당 약 213 토큰의 총 처리량을 기록하며 준수한 성능을 보여주었습니다. 하지만 이 시스템은 구조적으로 "배치 디코딩 엔진(batched-decode engine)이 아니기 때문에, 섹션 수보다 더 많은 요청을 보내는 것은 큰 이로가 없다"는 명확한 한계점도 함께 드러냈습니다.
그럼에도 불구하고 설계자의 로드맵은 멈추지 않습니다. 그는 Reddit을 통해 "DGX Sparks가 가진 기능 중 내가 간절히 원하는 유일한 것"인 '배치 디코딩(batched decoding)' 기술을 심도 있게 연구할 계획임을 밝혔습니다. 또한, 시스템 재시작 후에도 대화 기록과 문서 데이터가 안전하게 유지될 수 있도록 'conversation store' 기능을 다시 활성화하는 작업도 준비 중입니다. 비록 수치적인 데이터가 실제 사용 환경에서의 "답변 품질(answer quality in use)"을 완벽히 보증할 수는 없지만, 이 커스텀 서버는 지난 월요일부터 그의 기본 DeepSeek 머신으로 자리 잡았으며, 그는 이 모델이 마치 과거의 "Opus 4.6"이 보여주었던 놀라운 경험을 재현하고 있다고 극찬했습니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 기존/이전 세대 설정 | 이번 프로젝트 시도 및 결과 | 핵심 차이 및 한계점 |
|---|---|---|---|
| 전력 제한 (Power Cap) | 150W ~ 175W | 200W로 상향 시도 | 200W 부하 시 호스트 전원 차단 발생 |
| 클럭 속도 (Clock Cap) | 1,522 MHz | 1,452 MHz로 하향 조정 | 전력 효율과 정밀도 사이의 균형 추구 |
| 소프트웨어 최적화 | 기본 상태 유지 | 4종 최적화 기법 적용 시도 | 목표 성능 미달로 인해 현재 비활성화 |
| 데이터 처리량 (Throughput) | 단일 요청 위주 | 128K 컨텍스트 3개 동시 요청 | 배치 디코딩 미지원으로 확장성 한계 존재 |
| 모델 체감 성능 | 일반적인 DeepSeek 경험 | Opus 4.6 수준의 성능 체감 | 월요일부터 기본 DeepSeek 머신으로 활용 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
💡 개인용 AI 서버 구축을 위한 체크리스트
- [ ] 전력 공급 안정성 확보: GPU 전력 제한을 높일 경우, 호스트 시스템이 차단(trip)되지 않도록 충분한 용량의 PSU를 갖추었는가?
- [ ] 데이터 전송 병목 확인: PEX88096 또는 PLX 8749 스위치 구조에서 발생하는 PCIe 브릿지 지연(latency)이 성능에 미치는 영향을 고려하였는가?
- [ ] 최적화 목표 설정: 소프트웨어적 최적화(Expert Packing 등) 적용 시, 단순 적용이 아닌 명확한 성능 목표(target)를 설정하였는가?
❓ 자주 묻는 질문 (FAQ)
Q1. 다중 요청을 무작정 늘리면 처리 속도가 계속 빨라지나요? A1. 아닙니다. 현재 구성된 시스템은 '배치 디코딩 엔진'이 아니기 때문에, GPU 섹션 수보다 더 많은 요청을 한꺼번에 보내는 것은 성능 향상에 큰 도움이 되지 않습니다.
Q2. 이번 실험에서 사용된 4가지 최적화 기법은 왜 사용되지 못했나요? A2. conversation store, leaner hand-off, tighter expert packing, exact four-card-sum arithmetic 등 네 가지 기법 모두 설계자가 의도했던 성능 목표치(targets)를 충족하지 못했기 때문에 현재는 비활성화된 상태입니다.
딥러너 (DeepLearner)이었습니다.
🔗 원문 참고 및 출처: Lawyer’s $9,450 private AI server of 12 used Nvidia V100s now runs every DeepSeek V4.1 Flash expert at 4-bit NVFP4


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성