
⚡ 결론 직답: 10만 개 이상의 가속기를 사용하는 AI 클러스터가 전력 및 냉각 한계로 단일 데이터 센터를 벗어나며, 여러 지역을 연결하는 '스케일 어크로스' 네트워크 기술이 필수적으로 요구되고 있습니다.
📌 3줄 핵심 요약
- AI 가속기 성능 향상이 통신 속도를 앞지르며, 10만 개 이상의 가속기를 포함한 대규모 시스템의 효율을 결정하는 네트워크 인프라의 중요성이 증대됨
- 기존의 스케일업(NVLink, UALink 등)과 스케일아웃(Ethernet, InfiniBand, HPE Slingshot 등)을 넘어, 지리적 거리를 연결하는 '스케일 어크로스' 도메인이 새로운 기술 과제로 부상함
- 구글의 'Virgo' 아키텍처와 Cisco, Marvell의 차세대 라우터 및 광인터커넥트 기술을 통해 분산된 클러스터를 하나의 시스템처럼 운용하려는 움직임이 본격화됨
📅 데이터 기준일: 2026-11-20 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
데이터 센터의 물리적 한계와 초거대 AI 클러스터의 등장#
최근 인공지능(AI) 기술의 폭발적인 성장과 함께 AI 클러스터의 규모가 급격히 커지면서, 기존 데이터 센터가 가진 물리적 공간과 전력 공급 능력의 한계가 수면 위로 떠오르고 있습니다. AI 모델의 크기가 커질수록 더 많은 연산 자원이 필요하지만, 단일 데이터 센터가 수용할 수 있는 전력량과 냉각 효율에는 분명한 물리적 임계점이 존재하기 때문입니다. 이러한 한계를 극복하기 위해 여러 시설과 심지어 서로 다른 지리적 영역에 흩어져 있는 컴퓨팅 자원을 하나로 연결할 수 있는 새로운 네트워크 아키텍처에 대한 요구가 그 어느 때보다 높아지고 있습니다.
이러한 기술적 흐름과 관련하여, 최근 열린 Supercomputing 2026 (SC26) 컨퍼런스에서는 매우 의미 있는 논의가 진행되었습니다. The Ohio State University(오하이오 주립대학교)의 연구진들은 고성능 네트워킹 기술의 진화 과정을 상세히 설명하며 주목을 받았습니다. 연구진에 따르면, 이토록 거대한 규모의 분산 컴퓨팅을 효율적으로 운영하기 위해서는 단순히 '더 빠른 네트워크 연결'을 확보하는 것 이상의 전략이 필요하다고 강조했습니다. 핵심은 서로 다른 지리적 영역에 위치한 데이터 센터들 사이에서 워크로드를 확장할 수 있는 '도메인 간 스케일 확장(scale across domains)' 기술의 중요성입니다.
현재 우리가 마주한 AI 클러스터의 규모는 상상을 초록합니다. 현대적인 AI 클러스터는 통상적으로 100,000개 이상의 AI 가속기(AI accelerators)와 잠재적으로 수백만 개의 CPU 엔드포인트(CPU endpoints)를 수용하고 있습니다. 이러한 거대 시스템은 네트워크 대역폭(bandwidth), 지연 시간(latency), 그리고 혼잡 관리(congestion management) 측면에서 엄청난 수준의 요구 사항을 발생시킵니다. 특히 우려되는 지점은 AI GPU의 연산 성능이 발전하는 속도가 데이터를 주고받는 통신 기술의 발전 속도보다 훨씬 빠르다는 점입니다. 즉, 아무리 강력한 성능을 가진 최신 AI GPU를 도입하더라도, 이를 뒷받침할 네트워크 성능이 따라오지 못한다면 실제 애플리케이션의 성능 향상은 기대만큼 나타나지 않는 '병목 현상'이 발생하게 됩니다. 결국 대규모 AI 시스템이 보유한 컴퓨팅 자원을 얼마나 효과적으로 활용할 수 있는가는 네트워크 인프라의 효율성에 달려 있다고 해도 과언이 아닙니다.
그동안 고성능 컴퓨팅(HPC) 시스템은 크게 두 가지 핵심 인터커넥트(interconnect) 영역에 의존해 왔습니다. 첫 번째는 스케일 업(Scale-up) 네트워크로, 이는 프로세서와 가속기를 밀접하게 통합된 시스템 내부에서 연결하는 역할을 합니다. 여기에는 AMD의 Infinity Fabric, Intel의 UPI, Nvidia의 NVLink, 그리고 최근 떠오르는 대안인 UALink와 같은 기술들이 포함됩니다. 두 번째는 스무스 아웃(Scale-out) 네트워크입니다. 이는 개별 서버나 랙 단위의 시스템들을 더 큰 클러스터로 묶어주는 역할을 하며, 주로 Ethernet, InfiniBand, HPE Slingshot, 그리고 최근 주목받는 Ultra Ethernet 기술에 의존합니다. 이 두 영역은 대역폭, 지연 시간, 확장성 측면에서 서로 다른 요구 사항을 가지고 있으며, 그 목적과 역할 또한 명확히 구분되어 운영되어 왔습니다.
하지만 이제 현대 AI 클러스터의 거대한 규모와 막대한 전력 소비량은 기존의 두 영역을 넘어선 세 번째 인터커넥트 도메인, 즉 '스케일 어크로스(Scale-across)'의 등장을 예고하고 있습니다. 기존의 스케일 아웃 네트워크가 주로 단일 데이터 센터 내부의 시스템들을 연결하는 데 집중했다면, 스케일 어크로스 아키텍처는 그 경계를 허뭅니다. 이는 서로 다른 빌딩, 서로 다른 캠퍼스, 나아가 서로 다른 지리적 지역(regions)에 걸쳐 고성능 연결성을 확장하는 것을 목표로 합니다. 데이터 센터의 물리적 한계를 넘어 컴퓨팅 자원을 전 지구적 규모로 연결하려는 이 새로운 시도는, 미래 AI 인프라의 지형을 완전히 바꾸어 놓을 핵심 기술이 될 것으로 보입니다.
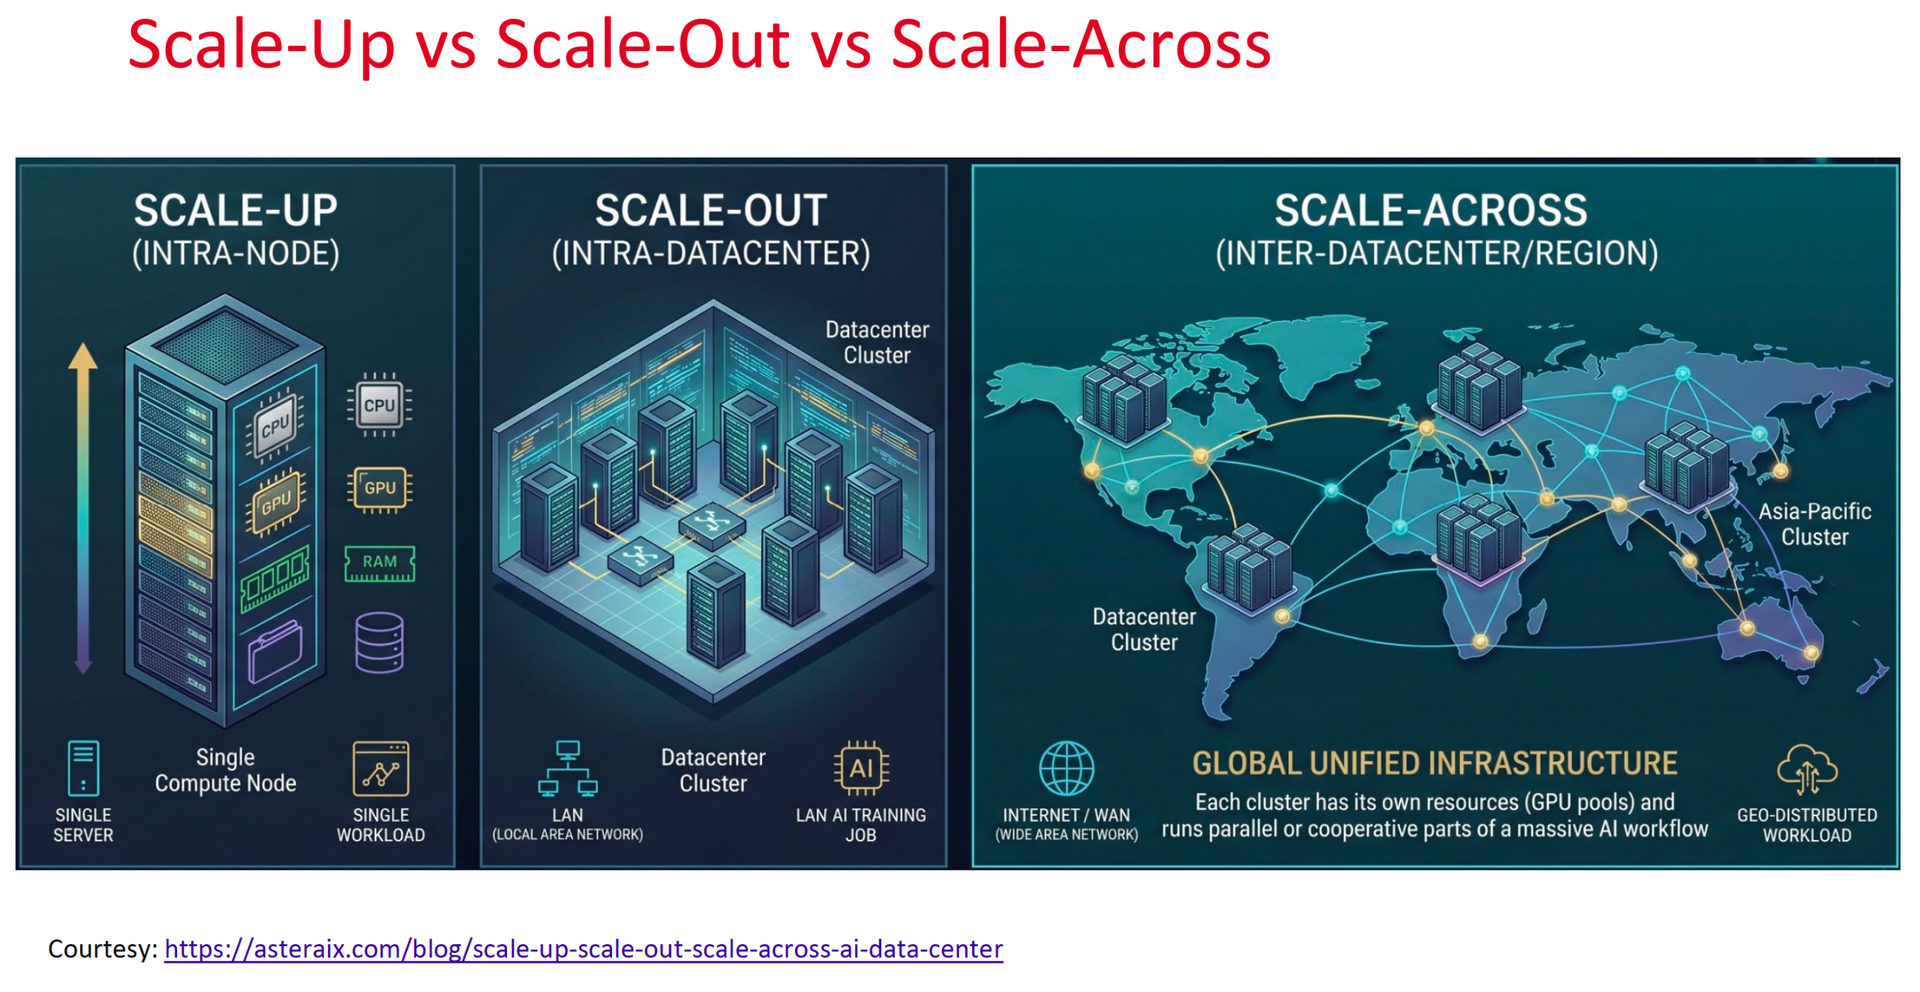
스케일업과 스케일아웃: 현대 AI 인프라를 구성하는 핵심 인터커넥트 기술#
반갑습니다, 테크 에디터 딥러너(DeepLearner)입니다. 최근 AI 산업의 폭발적인 성장으로 인해 10만 개 이상의 AI 가속기를 운용하는 초거대 클러스터 시대가 도래했습니다. 하지만 이러한 거대 시스템을 구축할 때 가장 큰 걸림돌은 역설적으로 '물리적 한계'입니다. 단일 데이터 센터에 무한정 가속기를 밀어 넣는 것은 전력 공급 능력, 냉각 효율, 그리고 물리적 공간의 제약으로 인해 사실상 불가능에 가깝기 때문입니다. 이를 해결하기 위해 최근 업계에서는 단일 센터의 경계를 넘어 여러 지역의 자원을 하나로 묶는 '스케일 어크로스(Scale-across)' 네트워크 기술이 새로운 돌파구로 떠오르고 있습니다.
기존의 인프라 구축 방식은 크게 두 가지 영역으로 나뉩붙습니다. 프로세서와 가속기를 밀접하게 연결하는 스케일업(Scale-up) 영역은 AMD의 Infinity Fabric, Intel의 UPI, Nvidia의 NVLink, 그리고 최근 부상하는 UALink와 같은 기술을 통해 고대역폭과 저지연성을 확보합니다. 반면, 개별 서버나 랙 단위의 시스템을 더 큰 클러스터로 묶는 스케일아웃(Scale-out) 영역은 Ethernet, InfiniBand, HPE Slingshot, 그리고 최신 기술인 Ultra Ethernet 등을 활용해 확장성을 확보해 왔습니다. 이제 업계는 이 두 영역을 넘어, 지리적으로 분산된 데이터 센터들을 하나의 거대한 컴퓨팅 자원으로 통합하려는 시도를 이어가고 있습니다.
현재 진행 중인 차세대 인터커넥트 기술의 핵심 요소들을 정리해 드립니다.
- Google의 Virgo 네트워크 아키텍처: 올해 초 Google이 도입한 이 아키텍처는 단일 데이터 센터의 공간 및 전력 용량을 초과하는 AI 워크로드를 지원하기 위해 설계되었습니다. 컴퓨팅 시설이 모인 전체 캠퍼스를 마치 하나의 거대한 시스템처럼 취급하여 운용하는 것이 핵심입니다.
- Scale-across를 위한 하드웨어 솔루션: Cisco와 Marvell은 지리적으로 분산된 클러스터를 연결하기 위해 고용량 라우터(High-capacity routers), 스위칭 칩(Switching chips), 그리고 광학 인터커넥트(Optical interconnects) 등 혁신적인 기술 개발에 박차를 가하고 있습니다.
- 네트워크의 물리적 장애 요인: 장거리 연결 시 발생하는 전파 지연(Propagation delays)은 광학 네트워크로도 완전히 제거할 수 없으며, 여기에 혼잡(Congestion), 패킷 손실(Packet loss), 그리고 동기화 오버헤드(Synchronization overhead)가 더해져 실질적인 성능 저하를 야기합니다.
- AI 학습의 핵심 통신 데이터: 대규모 AI 학습 과정에서는 가속기 간에 모델 파라미터(Model parameters), 그래디언트(Gradients), 그리고 중간 결과물(Intermediate results)을 빈번하게 교환해야 하며, 이 과정에서의 효율적인 집합 통신(Collective communications)이 전체 클러스터의 성능을 결정짓습니다.
이처럼 기술적 난제는 매우 복잡합니다. 단순히 두 개의 대규모 GPU 클러스터를 고속 링크로 연결한다고 해서, 이들이 곧바로 하나의 긴밀하게 통합된 컴퓨팅 시스템처럼 동작하는 것은 아니기 때문입니다. 현대의 스케일업 네트워크가 짧은 거리 내에서 극도로 높은 대역폭과 낮은 지연 시간을 제공하는 것과 달리, 데이터 센터 간의 통신은 물리적 거리에 따른 근본적인 한계를 극복해야만 합니다.
특히 대규모 AI 학습(AI training) 환경에서는 이러한 연결의 효율성이 생존과 직결됩니다. 개별 가속기에서 발생하는 미세한 지연이 클러스터 전체의 성능을 급격히 떨어뜨릴 수 있기 때문입니다. 따라서 분산 컴퓨팅의 효율성을 극대화하기 위해서는 단순한 네트워크 대역폭(Raw network bandwidth)의 확장을 넘어, 정교한 네트워크 토폴로지(Network topology), 혼잡 관리(Congestion management), 통신 프로토콜(Communication protocols), 그리고 이를 뒷받침하는 소프트웨어 구현(Software implementations)까지 아우르는 종합적인 설계가 필요합니다. 결국, 더 정교한 하드웨어와 소프트웨어의 결합만이 전력과 냉각의 한계를 넘어선 진정한 의미의 '스케일 어크로스' 시대를 열 수 있을 것입니다.
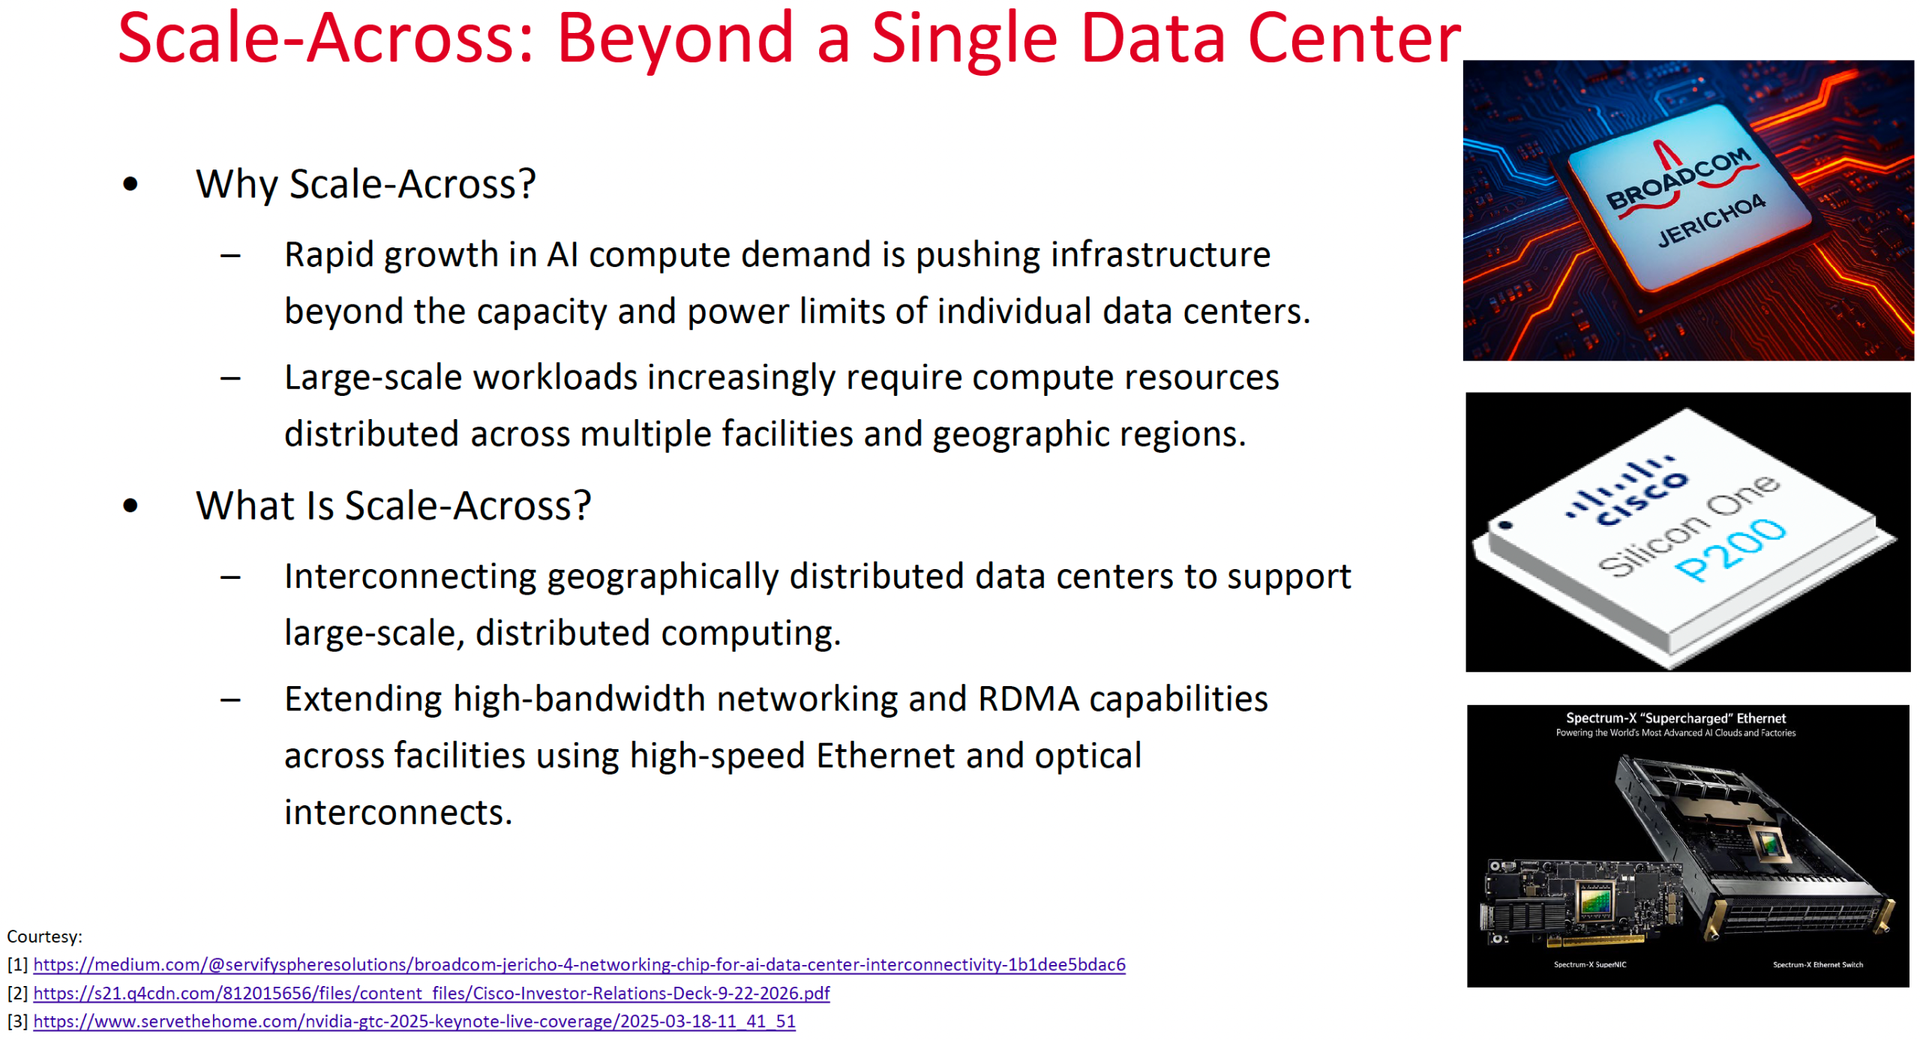
새로운 패러다임 '스케일 어크로스'와 글로벌 테크 기업의 기술 경쟁#
안녕하세요, 테크 에디터 딥러너(DeepLearlar)입니다. 인공지능(AI) 인프라의 규모가 기하급수적으로 커지면서, 이제 단순히 더 빠른 프로세서를 확보하는 것만으로는 한계에 봉착했습니다. 최근 주목받는 '스케일 어크로스(scale-across)' 아키텍처의 등장은 네트워크 기술이 단순히 데이터를 전달하는 통로를 넘어, 인프라의 핵심적인 연산 주체로 진화하고 있음을 보여줍니다.
이러한 한계를 극복하기 위해 네트워크 어댑터와 스위치는 그 어느 때보다 정교해지고 있습니다. 현대적인 네트워크 인터페이스 컨트롤러(NIC)는 CPU의 지속적인 개입 없이도 원격 직접 메모리 접근(RDMA, Remote Direct Memory Access) 작업을 수행할 수 있는 능력을 갖추고 있습니다. 특히 HPE Slingshot 하드웨어 컬렉티브(hardware collectives)나 Nvidia SHARP와 같은 혁신적인 기술은 특정 통신 연산 작업을 네트워크 인프라 자체로 오프로드(offload)하여 처리할 수 있게 해줍니다. 여기에 SmartNIC와 데이터 처리 장치(DPU, Data Processing Units)가 더해지면서, 선택적인 네트워크 및 인프라 기능을 전용 하드웨어에서 직접 처리함으로써 호스트 프로세서의 부하를 획기적으로 줄여주고 있습니다. 이러한 기술적 진보는 물리적인 인터커넥트 속도를 무조건 높이지 않더라도 분산 애플리케이션의 효율성을 극대화할 수 있는 길을 열어주었습니다.
흥미로운 점은 하드웨어만큼이나 소프트웨어의 역할 또한 대규모 AI 인프라의 성능을 결정짓는 핵심 요소라는 점입니다. libfabric, MPI, 혹은 UCX와 같은 통신 프레 가트워크(communication frameworks)는 애플리케이션이 데이터를 어떻게 교환하고 현대적인 네트워크 어댑터의 기능을 어떻게 활용할지를 결정하기 때문입니다. 연구자들에 따르면, GPU-aware 통신 기술과 GPUDirect RDMA와 같은 기술은 호스트 메모리를 거치는 불필요한 데이터 전송 과정을 제거할 수 있습니다. 또한, 최적화된 컬렉티브 연산(collective operations)은 수만 개의 가속기가 연결된 환경에서 발생하는 통신 오버헤드를 줄이는 데 결정적인 역할을 합니다.
결과적으로 AI 인프라의 복잡성이 증가함에 따라, 운영자들이 네트워크 성능을 평가하는 방식 또한 근본적으로 변화하고 있습니다. 업계에서는 명목 대역폭이 800 Gb/s 및 1.6 Tb/s에 이르는 GbE(Gigabit Ethernet)의 새로운 버전들을 포함하여 더 빠른 인터커넌트 기술을 끊임없이 도입하고 있습니다. 하지만 단순히 피크 전송률(peak transfer rates) 수치만으로는 시스템의 전체 역량을 온전히 설명할 수 없습니다. 실제 애플리케이션의 성능은 네트워크 하드웨어와 소프트웨어가 얼마나 효과적으로 협력하여 데이터를 전송하고, 혼잡(congestion)을 방지하며, 수천 개의 프로세서에 걸쳐 계산을 동기화(synchronize)하느냐에 달려 있기 때문입니다.
결국, 스케일 어크로스 상호 연결 아키텍처의 출현은 AI 인프라 설계의 근본적인 패러다임 전환을 의미합니다. 개별 가속기의 연산 능력이 향상되고 AI 클러스터가 단일 시설의 경계를 넘어 확장됨에 따라, 효율적인 통신은 이제 프로세서의 성능만큼이나 중요한 가치가 되었습니다. 따라서 차세대 AI 시스템의 성패는 단순히 더 빠른 AI 가속기나 CPU를 확보하는 것에 그치지 않을 것입니다. 정교한 네트워크 어댑터와 스무스한 스위치, 그리고 무엇보다 과도한 통신 오버헤드 없이 지리적으로 분산된 컴퓨팅 자원을 하나로 묶어줄 수 있는 고도화된 소프트웨어 기술에 달려 있다고 해도 과언이 아닙니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 기존 방식 (Traditional) | 신규 변화 (Scale-across/Advanced) | 핵심 차이 |
|---|---|---|---|
| CPU 역할 | 모든 통신 및 데이터 처리 시 CPU 개입 필수 | RDMA 및 오프로딩을 통한 CPU 부하 최소화 | CPU는 연산에 집중, 통신은 네트워크가 전담 |
| 네트워크 기능 | 단순 데이터 전달 통로 역할 | SmartNIC/DPU를 통한 네트워크 자체 연산 수행 | 네트워크 인프라가 연산의 일부를 분담 |
| 데이터 전송 경로 | 호스트 메모리를 거치는 불필한 전송 발생 | GPUDirect RDMA를 통한 GPU 간 직접 전송 | 호스트 메모리 병목 현상 제거 |
| 성능 평가 지표 | 단순 대역폭(Bandwidth) 및 전송 속도 중심 | 하드웨어-소프트웨어 협업 및 혼잡 제어 능력 | 단순 속도보다 시스템 전체의 동기화 효율 중시 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
💡 차세대 AI 인프라 도입을 위한 체크리스트
- [ ] 네트워크 어댑터가 CPU 개입 없이 RDMA 작업을 수행할 수 있는가?
- [ ] libfabric, MPI, UCX 등 최신 통신 프레임워크가 도입된 하드웨어를 지원하는가?
- [ ] 800 Gb/s 이상의 고대역폭 환경에서 혼잡 제어(Congestion Control) 및 동기화 메커니즘이 갖춰져 있는가?
❓ 자주 묻는 질문 (FAQ)
Q1. 단순히 네트워크 대역폭(Gbps)만 높이면 AI 학습 속도가 빨라지나요? A1. 단순히 대역폭을 높이는 것만으로는 부족합니다. 800 Gb/s나 1.6 Tb/s 같은 높은 수치도 중요하지만, 실제 성능은 하드웨어와 소프트웨어가 얼마나 유기적으로 협력하여 데이터 혼잡을 막고, 수천 개의 프로세서 간에 계산을 얼마나 정밀하게 동기화하느냐에 따라 결정됩니다.
Q2. GPUDirect RDMA 기술이 왜 중요한가요? A2. 기존에는 GPU 간 데이터를 주고받을 때 반드시 호스트(CPU)의 메모리를 거쳐야 하는 번거로움이 있었습니다. GPUDirect RDMA는 이 과정을 생략하고 GPU 메모리에서 직접 데이터를 전송할 수 있게 하여, 불필요한 데이터 복사로 인한 지연 시간과 오버헤드를 획기적으로 줄여주기 때문입니다.
오늘 준비한 소식은 여기까지입니다. 인프라의 경계를 허무는 기술의 흐름을 읽는 데 도움이 되셨길 바랍니다.
딥러너 (DeepLearner)이었습니다.
🔗 원문 참고 및 출처: Power and cooling limits push 100,000+ accelerator AI clusters past single data centers


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성