
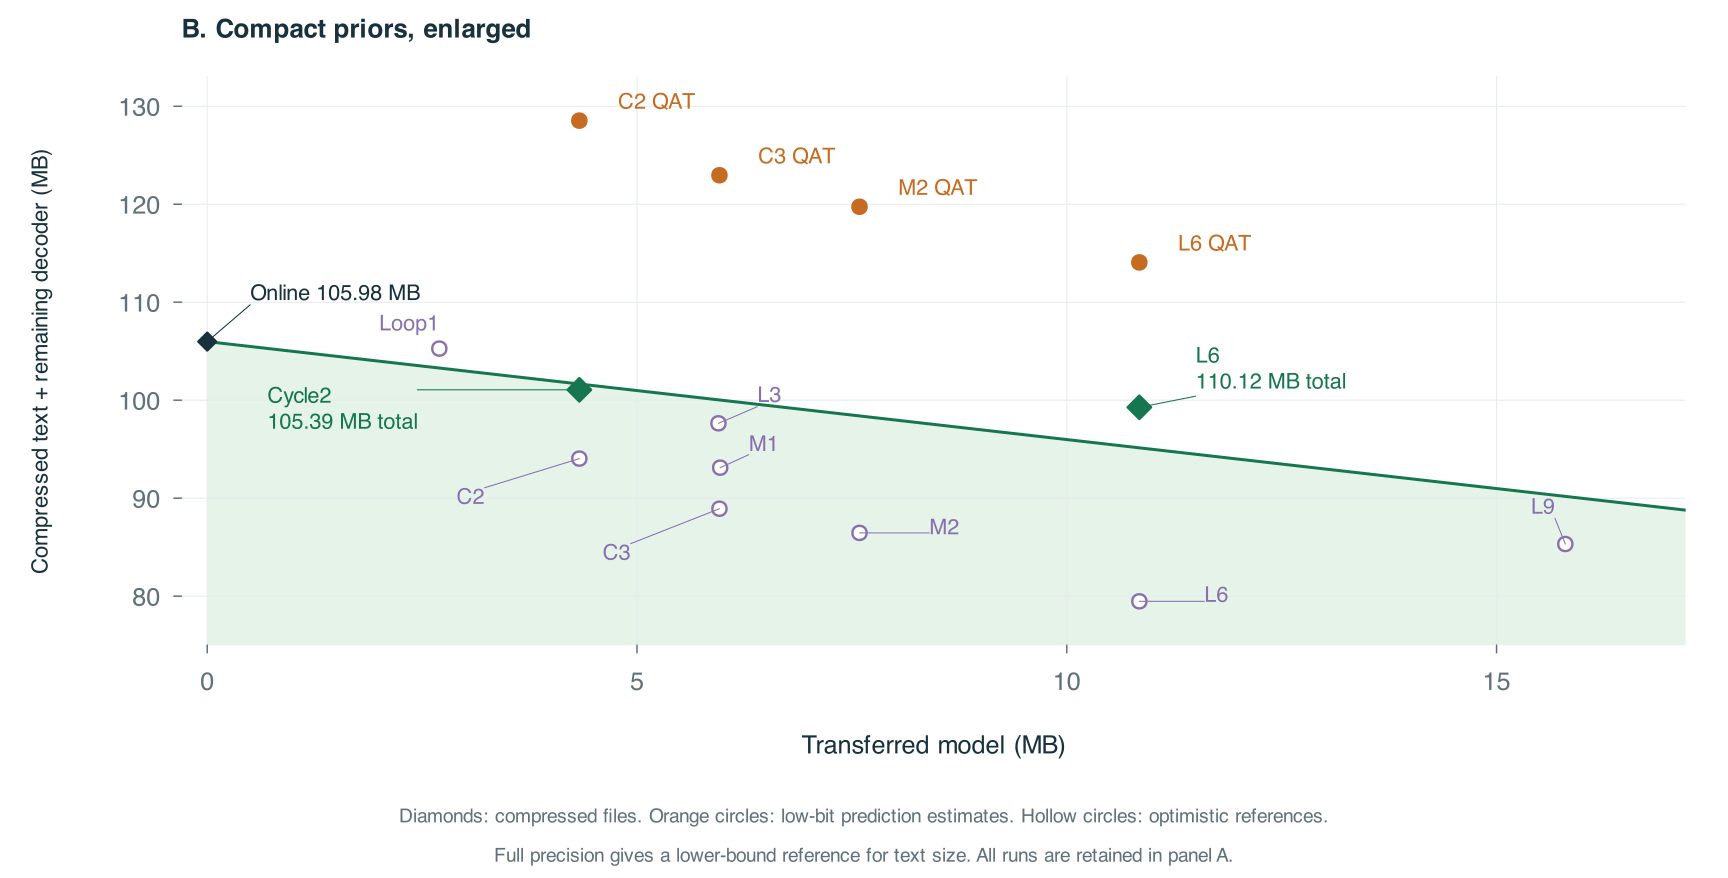
⚡ 결론 직답: Tufa Labs의 'tufazip'은 163M 파라미터 트랜스포머 모델을 활용해 1GB의 위키피디아 데이터를 105.39MB로 무손실 압축하는 데 성공했습니다.
📌 3줄 핵심 요약
- 163M 파라미터 규모의 12레이어 트랜스포머 모델을 활용하여 별도의 수동 모델 없이 신경망 단독으로 텍스트를 예측 및 압축합니다.
- 1GB 데이터를 105.39MB로 압축하며, 이를 위해 4.33MB의 사전 학습된 스타터 모델과 Nvidia B200 GPU 2대 및 Intel Xeon CPU 2대가 사용됩니다.
- 기존 방식과 달리 수동 모델을 배제한 순수 신경망 기반 압축 방식 중 벤치마크 내 최소 결과값을 기록하며 연구적 가치를 입증했습니다.
📅 데이터 기준일: 2026-11-21 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
최근 AI 기술의 발전이 데이터 압축 분야에서도 혁신적인 이정표를 세웠다는 소식이 전해졌습니다. 단순히 데이터를 줄이는 것을 넘어, 인공지능 모델 자체가 압축의 핵심 엔진이 되는 시대가 다가오고 있습니다.
1GB 위키피디아를 105MB로, AI 트랜스포머 기반 무손실 압축 'tufazip' 등장#
Tufa Labs의 최신 연구 포스트에 따르면, 'tufazip'이라는 새로운 기술이 1GB 분량의 위키피디아 정보를 단 105MB의 공간으로 무손실 압축하는 데 성공했습니다. 이 기술의 가장 놀라운 점은 사람이 직접 설계한 기존의 규칙 기반 모델(hand-built models)을 전혀 사용하지 않았다는 것입니다. 대신 1억 6,300만 개의 파라미터(163-million-parameter)를 가진 트랜스포머(Transformer) 모델을 데이터의 다음 내용을 예측하는 '예측기(predictor)'로 활용했습니다. 이는 'Large Text Compression Benchmark'에 참여한 모든 항목 중, 신경망을 유일한 예측기로 사용한 사례 중에서 가장 작은 압축 결과라는 놀라운 기록을 세웠습니다.
2026년 11월 19일 공개된 이 기술의 메커니즘은 매우 정교합니다. 기존의 상위권 압축 방식들은 트랜스포머 모델에 사람이 만든 모델을 혼합하여 사용해 왔으나, tufazip은 오로지 신경망만을 단독으로 사용하여 압축 효율을 극대화했습니다. 다만, 이 혁신적인 압축이나 압축 해제 과정을 수행하기 위해서는 막대한 컴퓨팅 자원이 필요합니다. 유사한 수준의 작업을 처리하기 위해서는 두 대의 Nvidia B200 GPU를 사용하여 약 일주일 정도의 시간이 소요될 것으로 예상됩니다.
이 프로젝트를 이끈 연구자 Tommy He는 최적화 과정을 거쳐 최종적으로 105.39MB라는 경이로운 결과물을 만들어냈습니다. 압축된 파일을 풀기 위해서는 4.33MB 크기의 사전 학습된 '스타터 모델(starter model)'이 반드시 필요한데, 이 모델은 저장 공간을 절약하기 위해 저정밀도(low precision)로 양자화(quantized)된 상태로 포함되어 있습니다. 전체 모델은 12개의 레이어로 구성된 트랜스포머 구조를 갖추고 있어, 각 예측 단계마다 12개의 스테이지를 거치게 됩니다. 스타터 모델은 이미 학습이 완료된 2개의 스테이지를 저장하고 있으며, 전체 모델이 메모리에 로드되면 이 데이터를 복사하여 12개의 스테이지를 채워나가는 방식을 취합니다. 이때 각 복사본은 독립적으로 학습을 지속하며 모델을 강화합니다.
주목할 점은 tufazip이 우리가 흔히 접하는 챗봇이나 클라우드 기반 AI와는 완전히 다른 방식으로 작동한다는 것입니다. 이는 실시간으로 학습하며 스스로 작동하는 '자기 완결형 언어 모델(self-contained language model)'에 가깝습니다. 특히 이번 압축의 핵심은 데이터 손실이 전혀 없는 '무손실(lossless)' 방식이라는 점입니다. 따라서 압축 과정에서 예측기의 업데이트는 반드시 '완전한 결정론적(fully deterministic)' 방식을 따라야 하며, 어떠한 데이터 왜곡도 허용되지 않습니다.
학습 프로세스는 총 2단계로 체계적으로 나뉩니다. 첫 번째 단계는 압축을 시작하기 전, 3,400만 개의 파라미터(34-million-parameter)를 가진 스타터 모델을 오프라인에서 미리 학습시키는 과정입니다. 그 후, 두 번째 단계인 '온라인 학습'이 시작됩니다. 모델이 각 토큰을 예측하고 그 결과에 따라 즉각적으로 학습을 진행하며, 압축 해제 측에서도 동일한 단계를 반복하여 텍스트와 함께 모델을 재구축하게 됩니다. 이러한 특성 때문에 최종 압축 파일의 크기에는 압축된 텍스트와 압축 해제 프로그램, 그리고 스타터 모델을 포함한 필수 파일들만 포함됩니다. 학습이 완료된 전체 모델 자체는 파일 크기에 포함되지 않도록 설계되어 효율성을 극대화했습니다.
12레이어 모델과 온라인 학습을 통한 자기 학습형 압축 메키니즘 분석#
최근 AI 압축 기술의 새로운 지평을 열었다고 평가받는 tufazip의 기술적 핵심은 기존의 압축 방식과는 완전히 궤를 달리한다는 점에 있습니다. Tufa Labs의 발표에 따르면, 현재 Large Text Compression Benchmark에서 상위권을 차지하고 있는 12개의 모델은 모두 Transformer 모델에 전통적인 방식의 hand-built models(수작업으로 설계된 모델)를 결합하여 성능을 보완하고 있습니다. 하지만 tufazip은 이러한 외부의 도움 없이 오직 신경망 기반의 예측기만을 사용하여 압축을 수행한다는 점에서 독보적인 차별성을 가집니다.
이러한 기술적 실험은 순위의 변동을 동반하며 발전해 왔습니다. tufazip의 첫 번째 online-only version은 지난 9월 초 제출 당시 벤치마크에서 2위를 기록하며 주목받았습니다. 이후 최적화 과정을 거쳐 탄생한 105.39MB 버전은 11월 19일 업데이트된 벤치마크 기준으로 13위에 이름을 올렸습니다. 여기서 주의 깊게 살펴봐야 할 점은, 이 실험이 미디어 파일이 아닌 오직 text-unly(텍스트 전용) 벤치마크를 대상으로 진행되었다는 사실입니다. 이는 영상이나 이미지 압축과는 다른, 언어 모델 기반의 순수 텍스트 압축 효율에 집중하고 있음을 의미합니다.
기술적 성취는 놀랍지만, 이를 실제 상용 제품으로 보기에는 아직 넘어야 할 산이 많습니다. tufazip의 작동 방식은 우리가 흔히 사용하는 WinRAR와 같은 범용 압축 소프트웨어와는 차원이 다른 컴퓨팅 자원을 요구하기 때문입니다. 현재 이 모델을 구동하기 위해서는 연구용 수준의 초고성능 하드웨어가 필수적입니다. 구체적인 기술 스펙과 연산 효율을 살펴보면 다음과 같습니다.
- 하드웨어 구성 및 연산 환경: Nvidia B200 GPU 2개와 Intel Xeon Platinum 8570 CPU 2개가 탑재된 테스트 머신을 기반으로 작동합니다.
- 압축 및 해제 소요 시간: 105.39MB 버전을 기준으로 압축에는 631,548초, 해제에는 645,748초가 소요됩니다. 이는 사전 학습(offline training) 시간을 제외하고도 각각 약 7.3일과 7.5일이라는 엄청난 시간이 필요함을 나타냅니다.
- 메모리 점유율(Peak Usage): 압축 과정 중 GPU VRAM은 최대 43.37 GiB에 달하며, 전체 시스템 메모리 사용량은 압축 시 약 68,525 MiB, 해제 시 약 73,748 MiB까지 치솟습니다.
- 이전 버전과의 성능 비교: 초기 버전인 105.98MB 모델의 경우, 압축에 647,595초, 해제에 630,136초가 소요되어 현재 버전과 비교했을 때 연산 효율 면에서 차이를 보였습니다.
이처럼 막대한 시간이 소요된다는 점은 tufazip이 현재로서는 일반 사용자를 위한 제품이 아닌, 순수한 research purposes(연구 목적)를 위해 설계되었음을 명확히 보여줍니다. 압축 과정에서 발생하는 연산량과 메모리 점유율은 기존의 어떤 압축 알고리즘보다도 압도적입니다. 하지만 이러한 극단적인 자원 소모에도 불구하고, 수작업 모델 없이 오직 트랜스포머 모델의 예측력만으로 1GB의 위키피디아 데이터를 105MB로 줄여냈다는 점은 AI 모델의 압축 잠재력이 어디까지 뻗어 나갈 수 있는지를 증명하는 중요한 이정표가 됩니다.
결국 tufazip의 진정한 가치는 '얼마나 빠르게 압축하느냐'가 아니라, '신경망이 데이터의 패턴을 얼마나 완벽하게 학습하여 무손실로 재구성할 수 있느냐'에 있습니다. 비록 현재는 7일이 넘는 시간이 걸리는 실험적인 단계에 머물러 있지만, 이 메커니즘이 고도화되어 연산 효율성이 개선된다면 미래의 데이터 저장 및 전송 패러다임을 완전히 뒤바꿀 혁신적인 기술이 될 것으로 기대됩니다.
막대한 연산 비용과 연구 목적의 한한계: 기존 압축 모델과의 차별점#
이번 'tufazip' 실험이 학계와 테크 커뮤니티에 던진 가장 큰 화두는 단순히 '압축률' 그 자체가 아닙니다. 오히려 모델의 규모와 자원 투입량이 반드시 비례하는 결과로 이어지지 않는다는 '규모의 역설'을 증명했다는 점에 주목해야 합니다. 실험 과정에서 발견된 흥미로운 사실 중 하나는 어휘 사전(Vocabulary)의 크기가 무조건 크다고 해서 유리한 것은 아니었다는 점입니다. 실험 결과, 4K-word tokenizer가 오히려 8K나 16K 크기의 토크나이저보다 더 뛰어난 압축 성능을 보여주었습니다. 특히 위키피디아의 XML 마크업을 위한 전용 토큰을 별도로 할당했을 때는 오히려 압축 효율이 저하되는 현상이 관찰되었습니다. 이는 모델의 복잡도를 무작정 높이는 것이 최적의 해답이 아님을 시사합니다.
모델 파라미터(Parameter)의 크기 측면에서도 '거대 모델이 곧 우월함'이라는 공식은 깨졌습니다. 이번 데이터셋 실험에서는 267-million-parameter 모델이 오히려 188-million-parameter 모델보다 약간 낮은 성능을 기록하는 결과가 나타났습니다. 특히 파일 크기가 더 작은 100MB 버전의 데이터를 대상으로 실험했을 때는, 파라미터 규모가 약 77 million 수준에서 성능 향상이 정체(leveled off)되는 양상을 보였습니다. 이는 특정 데이터 규모에 최적화된 '적정 규모'의 존재를 암시하며, 무분경한 모델 확장이 자원 낭비로 이어질 수 있음을 경고합니다.
물론 더 정교한 예측을 위해 모델의 구조를 복잡하게 설계하는 시도도 있었습니다. 실험팀은 더 큰 6-layer offline 모델로부터 시작된 런(run)을 테스트했는데, 이 모델은 99.17MB라는 더 작은 페이로드(payload)를 예측해내는 데는 성공했습니다. 하지만 문제는 모델의 가중치(weights)가 너무 무거워졌다는 점입니다. 결과적으로 전체 파일 크기는 오히려 온라인 전용(online-only) 방식의 런보다 더 커지는 역효과를 낳았습니다. 이는 압축된 데이터 자체의 크기를 줄이는 것만큼이나, 모델이 차지하는 물리적 용량을 관리하는 것이 얼마나 어려운 과제인지를 극명하게 보여줍니다.
가장 뼈아픈 대목은 최적화를 위해 투입되는 연산 비용의 비효율성입니다. 압축률을 개선하기 위해 이미 처리된 텍스트의 윈도우(window)를 15 million tokens에서 35 million tokens로 확장하여 추가 학습을 진행했으나, 정작 페이로드는 단 1.21% 감소하는 데 그쳤습니다. 반면, 이를 위해 투입된 연산 비용(compute)은 무려 40%나 증가했습니다. 즉, 압축 효율을 미세하게 높이기 위해 감수해야 할 비용이 기하급한 수준이라는 것입니다. 결국 이번 연구의 핵심 결론은 최적화란 단순히 더 많은 자원을 쏟아붓는 문제가 아니며, 예측 품질과 모델 크기 사이의 '소멸 지점(vanishing point)'을 찾는 정교한 균형 감각이 필요하다는 것입니다. 향후 연구의 핵심 과제 또한 이 6-layer 모델의 트레이드오프(trade-off)를 어떻게 조절하여 예측 품질을 유지하면서도 모델 크기를 최소화할 것인가에 집중될 전망입니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 기존/대형 모델 방식 (High-scale) | tufazip 실험 결과 및 발견 | 핵심 차이점 |
|---|---|---|---|
| 어휘 사전 크기 (Vocabulary) | 8K ~ 16K 이상의 대규모 토큰 | 4K-word tokenizer 우세 | 작은 사전이 더 효율적일 수 있음 |
| 모델 파라미터 규모 | 267-million-parameter 등 대형화 | 188-million 및 77-million 최적화 | 모델이 커질수록 성능이 비례하지 않음 |
| 학습 윈도우 확장 비용 | 15M $\rightarrow$ 35M 토큰 확장 시도 | 1.21% 개선을 위해 40% 비용 증가 | 투입 비용 대비 낮은 압축률 이득 |
| 모델 구조 및 가중치 | 대규모 6-layer offline 모델 | 온라인 전용(Online-only) 방식 | 무거운 가중치는 전체 파일 크기를 키움 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
💡 AI 모델 최적화 적용 체크리스트
- [ ] 모델의 파라미터 크기를 늘리는 것이 실제 압축률(Payload) 향상으로 이어지는지 확인했는가?
- [ ] 어휘 사전(Vocabulary)의 크기가 과도하게 커져서 오히려 압축 효율을 떨어뜨리고 있지는 않은가?
- [ ] 학습 데이터의 윈도우를 확장할 때, 증가하는 연산 비용(Compute cost) 대비 실제 이득(Payload reduction)이 유의미한가?
❓ 자주 묻는 질문 (FAQ)
Q1. 이번 연구에서 사용된 하드웨어 사양과 소요 시간은 어느 정도인가요? A1. 이번 실험에는 2대의 Nvidia B200 GPU와 2대의 Intel Xeon Platinum 8570 CPU가 사용되었습니다. 105.39MB 버전의 데이터를 압축하는 데는 약 631,548초, 압축을 푸는(decompress) 데는 약 645,748초가 소요되었습니다. 이는 각각 약 7.3일과 7.5일에 달하는 엄청난 시간으로, 오프라인 학습 시간을 제외한 수치입니다.
Q2. 모델의 크기를 키우는 것이 왜 압축에 불리할 수 있나요? A2. 실험 결과에 따르면, 267-million-parameter 모델이 188-million-parameter 모델보다 성능이 낮게 나타나기도 했습니다. 또한, 6-layer 모델처럼 예측 성능(payload)을 높이기 위해 모델을 복잡하게 만들면, 모델 자체가 가진 가중치(weights)의 용량이 너무 커져서 결과적으로 전체 파일의 크기는 오히려 늘어나는 '트레이드오프' 문제가 발생하기 때문입니다.
딥러너 (DeepLearner)이었습니다.
🔗 원문 참고 및 출처: One gigabyte of Wikipedia losslessly compressed to 105.39MB with self-learning AI transformer model


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성