
⚡ 결론 직답: 개발자 WollyMonjac가 486DX 및 Pentium PC의 DOS 환경에서 구동 가능한 36.7만 파라미터 규모의 초소형 트랜스포머 모델 'Tiny 2.1'을 공개했습니다.
📌 3줄 핵심 요약
- Turbo C 2.0으로 작성된 Tiny 2.1은 486DX 및 Pentium PC의 DOS 환경을 타겟으로 한 초소형 질문 답변(QA) 트랜스포머 모델입니다.
- 367,000개의 파라미터와 8비트 가중치를 사용하여 전체 용량을 380KB로 압축했으며, 약 3,500개의 사실 데이터를 학습했습니다.
- PC 스피커를 통한 로봇 음성 출력과 레트로한 UI를 제공하며, MIT 라이선스로 배포되어 사용자가 직접 학습 데이터를 확장할 수 있습니다.
📅 데이터 기준일: 2026-11-22 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
최근 인공지능 기술의 흐름은 누가 더 많은 데이터를 학습하고, 얼마나 더 거대한 파라미터를 보유했느냐를 겨루는 '규모의 경제' 시대에 놓여 있습니다. 수천억 개의 파라미터를 가진 거대 언어 모델(LLM)들이 쏟아져 나오며 컴퓨팅 자원의 한계를 시험하고 있죠. 하지만 모든 기술이 앞을 향해 달려갈 때, 때로는 과거의 유산을 재조명하며 기술의 본질을 묻는 혁신적인 시도가 등장하곤 합니다. 오늘 전해드릴 소식이 바로 그러합니다.
1부: 486·Pentium 시대를 위한 귀환, DOS용 초소형 AI 'Tiny 2.1'의 등장#
최근 한 영감을 받은 개발자가 48mu6DX 및 Pentium PC를 사용하며 DOS 환경에서 작업하던 유저들을 위해, 놀랍게도 플로피 디스크 하나에 담길 정도의 초소형 AI 모델을 구현해냈습니다. 개발자 WollyMonjac이 선보인 이 프로젝트는 바로 'Tiny 2.1'이라는 이름을 가지고 있습니다.
여기서 한 가지 짚고 넘어가야 할 점은, WollyMonjac의 이번 프로젝트가 우리가 흔히 알고 있는 거대한 규모의 언어 모델(LLM)은 아니라는 사실입니다. 물론 Tiny 2.1 역시 거대한 형제 모델들과 마찬가지로 트랜스포머(Transformer) 아키텍처를 공유하고는 있지만, 개발자는 이 모델을 "Turbo C 2.0으로 작성된 아주 작은 질의응답용 트랜스포머(a tiny question-answering transformer)"라고 매우 겸손하게 정의했습니다. 90년대 초반의 클래식한 프로그래밍 언어인 Turbo C 2.0을 사용했다는 점만으로도, 이 프로젝트가 지향하는 레트로한 기술적 가치를 짐작할 수 있습니다.
현대적인 소프트웨어들의 방대한 용량을 생각하면, 플로피 디스크라는 저장 매체는 매우 척박한 환경입니다. 486 PC 시대의 전형적인 포맷된 디스크 용량은 약 1,475,000 바이트(bytes)에 불과할 정도로 매우 제한적이었기 때문입니다. 하지만 Tiny 2.1은 이 극도로 제한된 여유 공간을 최대한 활용하여, 마치 마법처럼 효율적인 구조를 설계해냈습니다.
그 구체적인 기술적 명세를 살펴보면 더욱 놀랍습니다. Tiny 2.1은 단 367,000개의 파라미터(parameters)만을 사용합니다. 구조적으로는 4개의 레이어(layers)와 96의 너비(96 wide)를 가지고 있으며, 데이터를 처리할 때 한 글자씩 읽고 쓰는(reads and writes letter by letter) 방식을 채택했습니다. 또한, 모델의 효율성을 극대화하기 위해 8비트 가중치(8-bit weights, 행당 하나의 스케일 적용)를 사용하였는데, 이 모든 것을 포함한 전체 모델의 크기는 단 380 KB에 불과합니다.
이는 현대의 AI 모델들이 테라바이트(TB) 단위의 저장 공간을 요구하는 것과 비교하면, 마치 거대한 산과 작은 모래알의 차이만큼이나 경이로운 압축률과 효율성을 보여주는 사례라고 할 수 있습니다. 낡은 하드웨어 위에서 구현된 이 작은 트랜스포머가 과연 어떤 질문에 답할 수 있을지, 그 기술적 가능성이 벌써부터 기대됩니다.
2부: 380KB의 극한 최적화, 36.7만 파라미터와 8비트 가중치의 기술적 구현#
단순히 크기를 줄인 것을 넘어, 'Tiny 2.1' 프로젝트의 진정한 가치는 제한된 자원 안에서 어떻게 정보의 밀도를 극대화했느냐에 있습니다. 이 모델은 방대한 데이터를 학습하는 현대의 거대 언어 모델(LLM)과는 완전히 다른 길을 걷습니다. 개발자는 약 3,500개의 사실(facts)을 기반으로 학습을 진행했는데, 주목할 점은 각 사실을 단 하나의 문장이 아니라 매우 다양한 문구(many wordings)로 변형하여 학습시켰다는 것입니다. 이는 모델의 파라미터 수가 극도로 적음에도 불구하고, 사용자의 다양한 질문 패턴에 대응할 수 있는 유연성을 확보하기 위한 고도의 전략적 선택이라 할 수 있습니다.
이러한 기술적 정수는 다음과 같은 구체적인 스펙과 인터페이스를 통해 확인할 수 있습니다.
- 학습 데이터의 정교함: 약 3,500개의 핵심 사실(facts)을 바탕으로 하며, 각 정보는 다양한 어조와 문구(many wordings)로 학습되어 문맥 이해력을 높였습니다.
- 메모리 점유 및 요구 사양: 구형 PC(486 또는 Pentium급)에서 실행하기 위해 약 540KB의 여유 있는 컨벤셔널 메모리(free conventional memory)를 필요로 합니다.
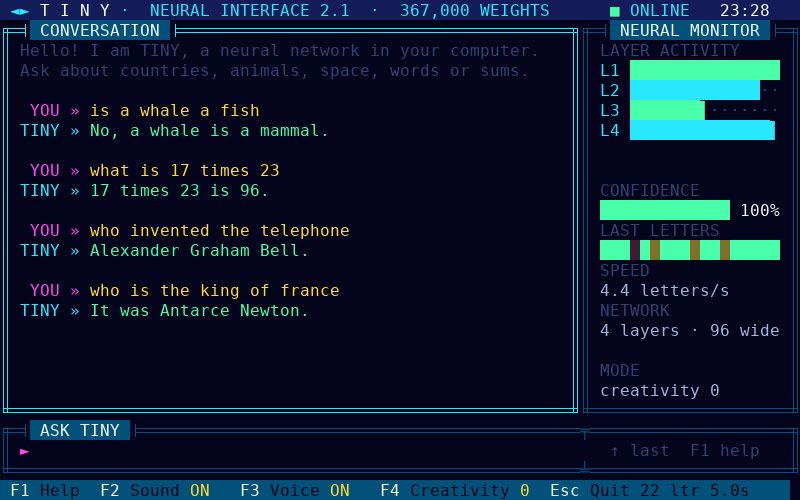
- 사용자 인터페이스(UI) 구성: 대화 기록을 확인할 수 있는 대화 히스토리 창(conversation history pane), 신경망의 상태를 모니터링하는 뉴럴 모니터 패널(neural monitor panel), 그리고 사용자가 질문을 입력하는 'Ask Tiny' 프롬프트 창(prompt window)으로 구성되어 있습니다.
- 조작 편의성 및 단축키: DOS 기반 프로그램의 정체성을 계승하여, UI 내에 다양한 F-key 단축키(F-key shortcuts)가 강조되어 있어 키보드만으로도 효율적인 조작이 가능합니다.
- 레트로 사운드 기능: 응답 내용을 음성으로 출력할 수 있는 PC-스피커 로봇 목소리(PC-speaker robot voice) 기능을 탑재하여, 마치 과거 SF 영화 속 컴퓨터를 사용하는 듯한 '레트로 퓨처리즘'의 정수를 보여줍니다.
사용자가 이 프로그램을 실제로 구동해 본다면, 텍스트 기반의 투박한 DOS 환경 속에서도 놀라울 정도로 깔끔하게 정리된 UI에 감탄하게 될 것입니다. 특히 대화의 흐름을 놓치지 않게 해주는 히스토리 창과 모델의 내부 작동을 시각화하는 뉴럴 모니터 패널은, 자칫 단순해 보일 수 있는 프로젝트에 기술적인 깊이를 더해줍니다. 여기에 더해, 별도의 사운드 카드 없이 메인보드에 내장된 PC 스피커를 통해 출력되는 로봇 목소리는 이 프로젝트의 화룡점정이라 할 수 있습니다.
개발자인 Monjac는 이 프로젝트에 대해 매우 겸손한 태도를 유지하고 있습니다. 실제 GitHub 저장소(repository)의 기록을 살펴보면, 이 프로그램은 "Fable 5.2에 의해 작성되었으며(Written by Fable 5.2), Opus 5.5에 의해 학습되었습니다(trained by Opus 5.5)"라고 명시되어 있습니다. 이는 마치 오픈 소스 생태계의 작은 기여자들이 모여 하나의 작은 우주를 만들어낸 듯한 인상을 줍니다.
물론 완벽한 모델은 아닙니다. 개발자 Monjac 또한 이 언어 모델이 학습되지 않은 영역에 대해서는 "매우 자신만만하게 지어낸다(it makes things up confidently)"라고 위트 있게 인정했습니다. 최근 AI 업계의 화두인 '환각 현상(hallucination)'이 거대 모델에서는 해결해야 할 심각한 오류로 다뤄지는 것과 달리, Tiny 2.1에서는 이러한 특성이 오히려 클래식한 소프트웨어의 재미있는 기능(fun feature)처럼 느껴진다는 점이 매우 흥미롭습니다. 기술적 한계를 기술적 묘미로 승화시킨 개발자의 재치가 돋보이는 대목입니다.
3부: 레트로 감성과 AI의 결합, PC 스피커 음성 지원부터 오픈소스 확장성까지#
만약 Tiny 2.1이 보유한 지식의 범위가 여러분의 기대에 미치지 못해 아쉬움이 남더라도, 너무 실망하실 필요는 없습니다. 개발자인 WollyMonjac은 MIT 라이선스로 배포되는 이 소프트웨어 패키지 안에 별도의 'training folder(학습 폴더)'를 포함해 두었기 때문입니다. 만약 기술적 열정이 있는 사용자라면, 이 폴란더를 활용해 자신이 평소 관심 있어 하는 특정 주제에 최적화된, 아주 유능한 질의응답용 트랜스포머(question-answer transformer)를 직접 구축해내는 것도 충분히 가능해 보입니다. 이는 단순한 복고풍 프로젝트를 넘어, 오픈소스를 통한 무한한 확장 가능성을 사용자에게 열어주었다는 점에서 매우 고무적입니다.
최근의 기술 트렌드를 살펴보면, 최신 하드웨어에서 오래된 소프트웨어를 구동하는 것은 이제 비교적 쉬운 일이 되었습니다. 하지만 우리가 주목해야 할 진정한 혁신은 그 반대의 방향, 즉 수십 년 전의 노후화된 하드웨어에서 현대적인 앱이나 게임을 구동하려는 시도에서 나타나고 있습니다. 이는 단순히 과거를 추억하는 것을 넘어, 기술적 한계를 극복하려는 매우 흥미로운 개발 트렌드로 자리 잡고 있습니다.
Tiny 2.1의 등장은 이러한 '신구(新舊)의 부조화'를 보여주는 대표적인 사례입니다. 이와 유사하게 상상하기 어려운 조합을 현실로 만들어낸 소프트웨어 프로젝트들은 이미 여러 차례 보고된 바 있습니다. 예를 들어, DOS 환경에서 구동되는 ChatGPT 클라이언트(ChatGPT client for DOS)나, Game Boy에서 실행되는 Minecraft, 그리고 C64(Commodore 64)에서 생성형 AI(generative AI)를 이용해 이미지를 생성하는 프로젝트, 심지어 Atari ST에서 Doom을 플레이하는 사례 등이 그 주인공입니다. 이러한 프로젝트들은 하드웨어의 물리적 한계를 창의적인 소프트웨어 공학으로 극복하려는 시도를 잘 보여줍니다.
한편, 이 프로젝트의 개발 이면에는 흥미로운 기록도 남아 있습니다. GitHub 저장소의 기록에 따르면, Tiny 2.1은 "Fable 5.2에 의해 작성되었고, Opus 5.5에 의해 학습(Written by Fable 5.2 and trained by Opus 5.5)"되었다고 명시되어 있습니다. 또한 개발자인 Monjac은 이 모델이 학습되지 않은 내용에 대해서는 "자신 있게 꾸며내는(makes things up confidently)" 특성이 있다고 위트 있게 인정하기도 했습니다. 최근 LLM(대규모 언어 모델) 분야에서 큰 화두가 되었던 '할루시네기이션(hallucination, 환각)' 현상이, 이 레트로 프로젝트에서는 오히려 고전적인 재미를 더해주는 요소로 작용하고 있다는 점이 인상적입니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 기존 방식 (Modern Hardware) | 신규 레트로 트렌드 (Retro Hardware) | 핵심 차이점 |
|---|---|---|---|
| 구동 대상 모델 | 고성능 대규모 언어 모델 (LLM) | Tiny 2.1 (Turbo C 2.0 기반) | 파라미터 수의 극적인 축소 (367,000개) |
| 하드웨어 환경 | 최신 GPU 및 대용량 RAM 기반 | 486/Pentium급 PC (540KB 메모리 필요) | 8-bit weights 및 극소량의 데이터 활용 |
| 소프트웨어 확장성 | 클라우드 API 및 대규모 데이터셋 | MIT 라이선스 기반 로컬 학습 폴더 제공 | 사용자가 직접 특정 주제로 재학동 가능 |
| 주요 사례 | 최신 게임 및 고사양 앱 | ChatGPT for DOS, Minecraft on Game Boy | 구형 하드웨어에서의 현대적 기능 구현 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
✅ Tiny 2.1 실행 전 체크리스트
- [ ] 사용 중인 486 또는 Pentium급 PC에 540KB 이상의 여유로운 conventional memory가 확보되었는가?
- [ ] PC 스피커를 통해 출력되는 로봇 음성(PC-speaker robot voice)을 즐길 준비가 되었는가?
- [ ] MIT 라이선스로 제공되는 training folder를 활용해 자신만의 데이터로 재학습할 계획이 있는가?
❓ 자주 묻는 질문 (FAQ)
Q1. Tiny 2.1의 답변이 사실과 다를 수 있나요? A1. 네, 그렇습니다. 개발자인 Monjac도 언급했듯이, 이 모델은 학습되지 않은 데이터에 대해 매우 자신감 있게 잘못된 정보를 생성하는 '할루시네이션' 특성을 가지고 있습니다. 이는 기술적 한계라기보다 이 프로젝트가 가진 유머러스한 특징 중 하나로 이해할 수 있습니다.
Q2. 이 프로젝트의 기술적 구성은 어떻게 되나요? A2. Tiny 2.1은 Turbo C 2.0 환경에서 작성되었습니다. 4개의 레이어와 96의 너비를 가진 367,000개의 파라미터로 구성되어 있으며, 약 3,500개의 사실(facts)을 바탕으로 학습되었습니다. 전체 모델 크기는 8-bit 가중치를 사용하여 약 380KB 정도의 매우 가벼운 용량을 자랑합니다.
딥러너 (DeepLearner)이었습니다.
🔗 원문 참고 및 출처: Dev squeezes an AI language model onto a floppy for 486DX and Pentium PC stalwarts


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성