
⚡ 결론 직답: 팔로알토 스타트업 Architect Labs의 AI 에이전트가 설계한 새로운 CPU 'Frostbite'는 7nm 시뮬레이션 결과 기존 코어 대비 전력 효율 4.59배를 기록하며 혁신적 아키텍처를 선보였습니다.
📌 3줄 핵심 요약
- Architect Labs의 AI 에이전트가 새로운 명령어 세트를 갖춘 범용 CPU 'Frostbite'를 밑바닥부터 설계, 검증 및 구현함
- 7nm 시뮬레이션 기준, 4-tile 클러스터가 기존 CPU 코어 대비 전력 효율 4.59배, 면적 효율 8.77배의 성능을 달성함
- '인터랙션 넷' 모델을 도입해 복잡한 캐시 계층 없이도 데이터 병렬성을 극대화하는 '무료 멀티스레딩' 기술을 구현함
📅 데이터 기준일: 2026-11-22 | 원문 출처 기반 심층 리포트
안녕하세요, 딥러너 (DeepLearner)입니다.
오늘 테크 업계의 이목을 집중시키고 있는 혁신적인 소식을 들고 왔습니다. 인공지능이 단순히 소프트웨어를 만드는 것을 넘어, 이제는 하드웨어의 근간이 되는 아키텍처를 설계하는 시대가 도래했습니다.
1부: AI 에이전트가 설계한 완전히 새로운 CPU 아키텍처 'Frostbite'#
팔로알토(Palo Alto)에 본사를 둔 스타트업 'Architect Labs'는 최근 자사의 연구 블로그를 통해 매우 놀라운 성과를 발표했습니다. 바로 자사의 AI 시스템이 직접 발견하고, 설계하며, 검증까지 마친 차세대 범용 CPU, 'Frostbite'의 등장입니다. Frostbite는 기존의 방식을 답습하는 것이 아니라, 완전히 새로운 명령어 세트(instruction set)를 바탕으로 '밑바닥부터(built from the ground up)' 재설계된 것이 특징입니다. 25개의 다양한 워크로드를 대상으로 진행된 테스트 결과는 가히 압도적이었습니다. 4개의 타일(tile)로 구성된 Frostbite 클러스터는 기존의 '실리콘 검증(silicon-prover)'을 마친 듀얼 이슈(dual-issue), 인오더(in-order) CPU 코어와 유사한 크기임에도 불구하고, 전력 대비 성능(performance per watt) 면에서 무려 4.59배라는 경이로운 수치를 기록했습니다. 다만, 이번 수치는 아직 실제 실리콘으로 제작되지 않은 7nm 공정의 시뮬레이션 설계 단계에서 도출된 결과이며, Architect Labs 측은 법적인 이유로 비교 대상이 된 코어의 명칭은 공개할 수 없다고 밝혔습니다.
그렇다면 Frostbite는 기존의 컨벤셔널(Conventional) CPU와 어떤 점에서 차별화될까요? 기존의 CPU들은 하드웨어가 런타임(runtime) 중에 어떤 명령어들이 서로 의존성을 가지는지 일일이 찾아내야 하는 복잡한 과정을 거칩니다. 또한, 멀티코어 설계의 특성상 모든 코어가 공유 메모리를 일관되게 바라볼 수 있도록 깊은 캐시 계층 구조와 일관성 프로토콜(coherence protocols)이 필수적인데, 이는 데이터의 일관성을 유지하기 위해 막대한 면적과 전력을 소모하며, 결과적으로 시스템의 확장성(scale)을 저해하는 주요 원인이 됩니다. 이에 대해 Architect Labs는 '무상 멀티스레딩(multithreading for free)'이라 불리는 대안적 방식을 제시했습니다. 이는 별도의 스레드나 락(lock), 혹은 의존성 파악을 위한 복잡한 아웃오브오더(out-of-order) 하드웨어를 사용할 필요 없이, 프로그램 자체가 병렬적으로 수행 가능한 작업을 스스로 드러내도록 설계된 방식입니다.
이러한 혁신적인 설계의 핵심은 '인터랙션 넷(interaction nets)'이라는 계산 모델에 있습니다. 이는 1990년에 제안된 계산 모델로, 프로그램을 노드(node)들의 그래프로 표현하고 연결된 노드 쌍을 재작성(rewriting)함으로써 연산을 수행하는 방식입니다. Frostbite의 칩 설계는 바로 이 독특한 패러다임을 중심으로 구축되었습니다. 재작성되는 노드 쌍은 서로 겹치지 않기 때문에, 어떤 순서로 실행하든 혹은 모든 노드를 동시에 실행하든 상관없이 항상 동일한 결과에 도달할 수 있습니다. 또한, 모든 값이 정확히 한 번만 사용된다는 특성 덕분에, 거대한 공유 캐시를 사용하는 대신 작고 효율적인 로컬 메모리만으로도 데이터를 충분히 관리할 수 있게 되어 전력 효율을 극대화했습니다.
이러한 차이를 극명하게 보여주는 구체적인 사례가 있습니다. 바로 5x5 체스판 위에서 5개의 퀸(queens)을 서로 공격할 수 없는 위치에 배치하는 문제입니다. 기존의 일반적인 프로그램은 한 번에 하나의 체스판 상태를 순차적으로 탐색하며 해답을 찾습니다. 하지만 인터랙션 넷 방식을 적용하면, 동일한 탐색 과정이 3,183개의 작은 연산 단위로 정교하게 쪼개집니다. 이때 가장 길게 이어지는 순차적 실행 체인(chain)은 단 262단계에 불과하며, 평균적으로 각 단계마다 약 12개의 연산이 동시에 실행 가능한 상태로 준비됩니다. 놀라운 점은 이 병렬성을 확보하기 위해 프로그램을 별도로 수정할 필요가 전혀 없었다는 것입니다. 병렬 작업 자체가 이미 프로그램 내에 내재(intrinsic)되어 있었기 때문입니다.
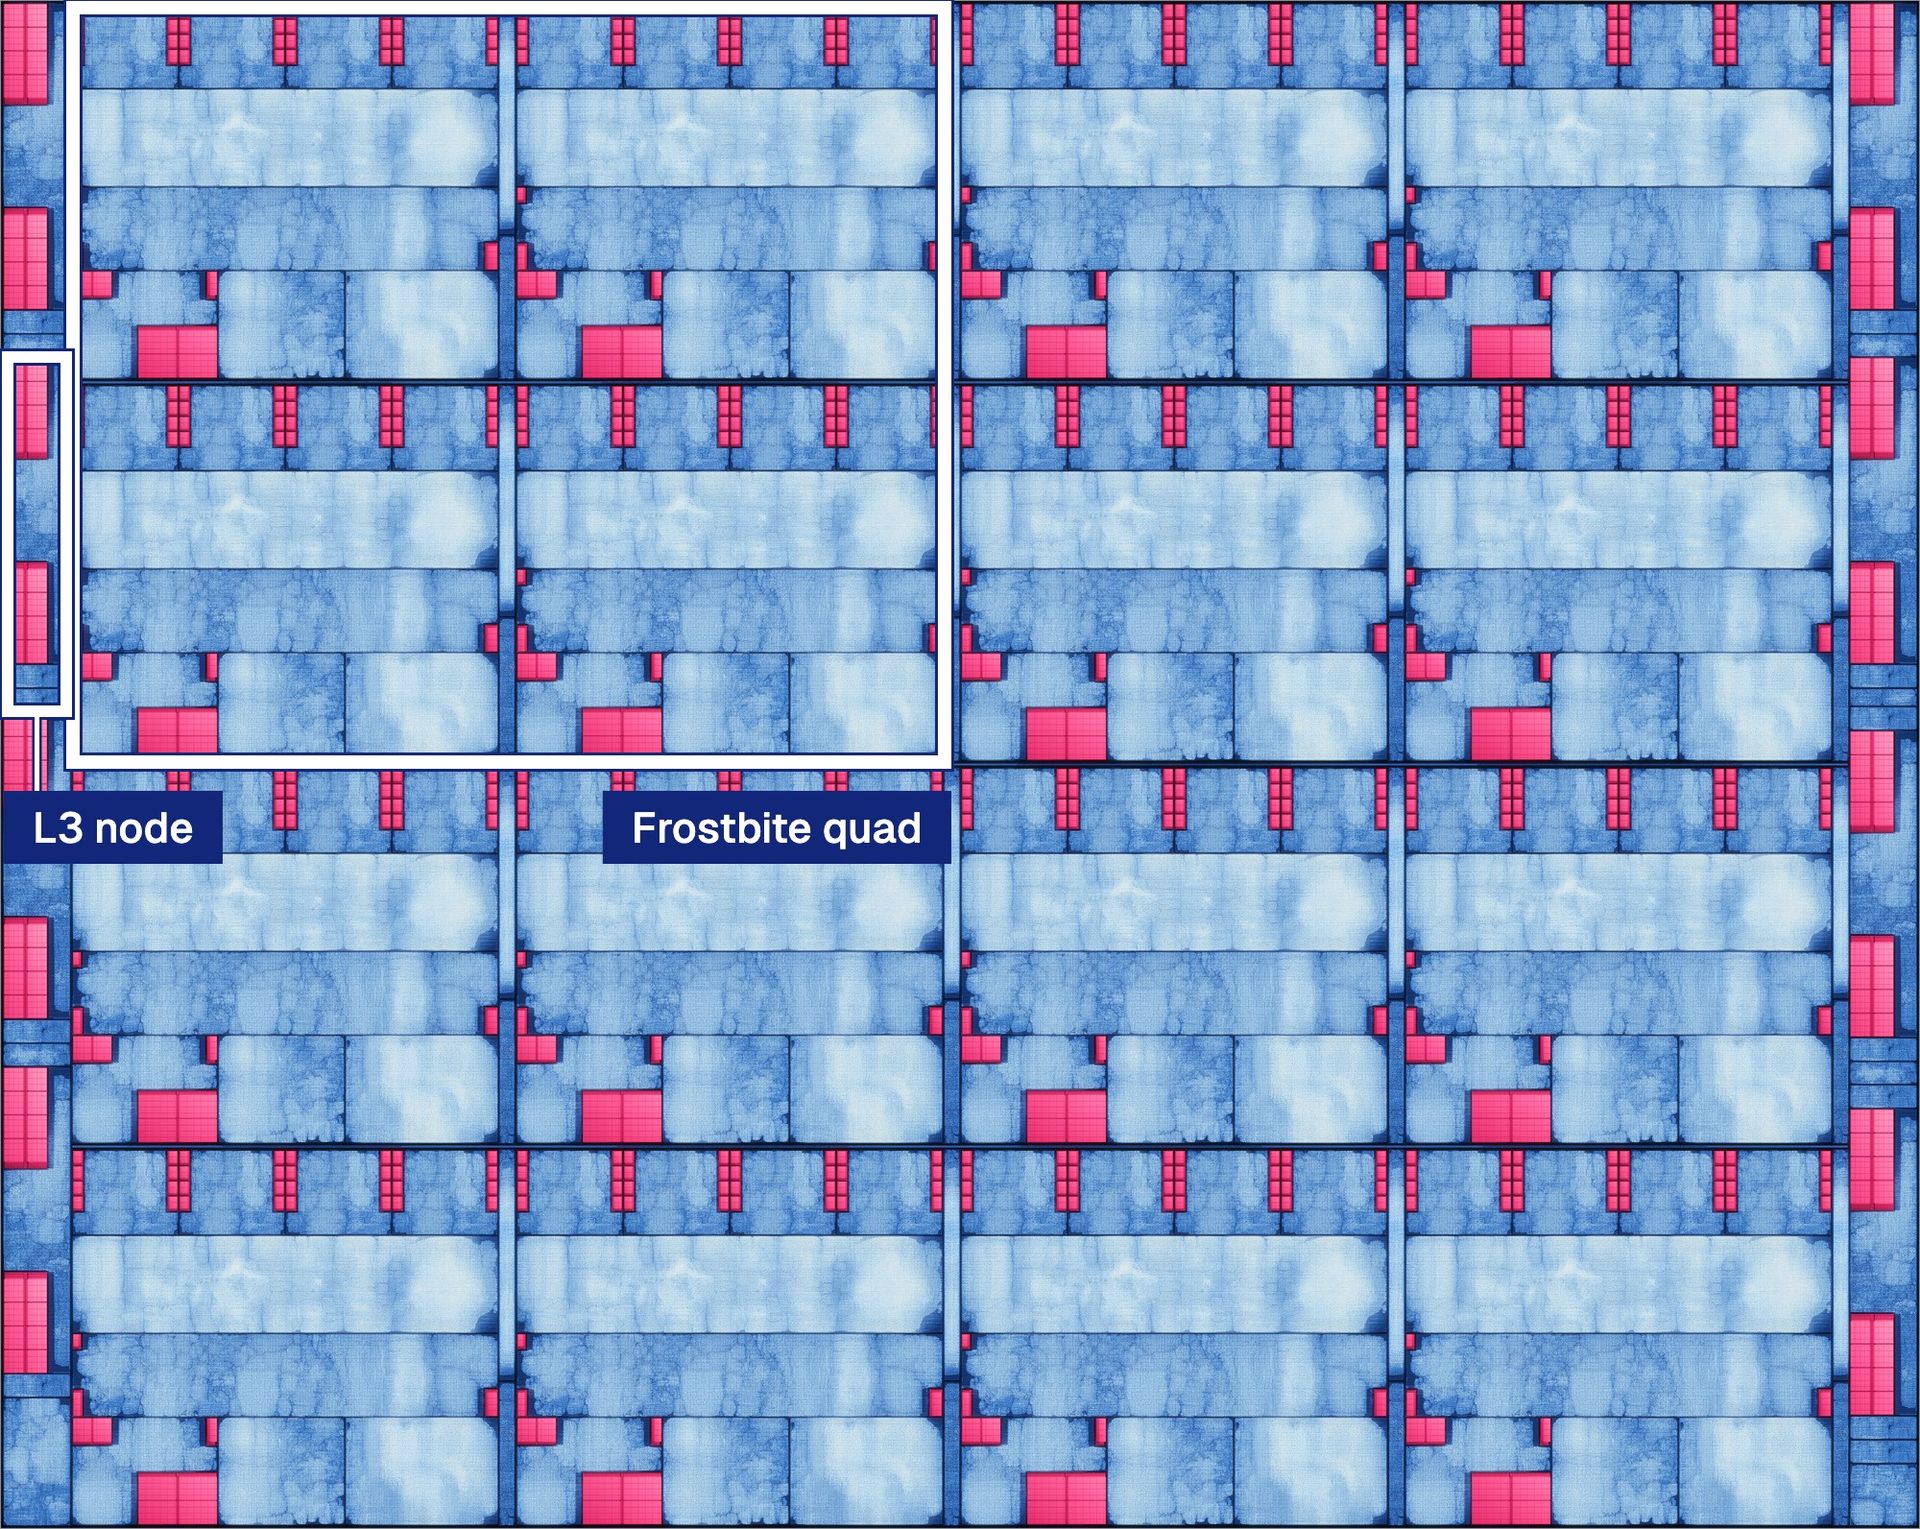
마지막으로 하드웨어의 물리적 구조와 성능 지표를 살펴보겠습니다. 칩 내부 네트워크로 연결된 작고 동일한 프로세싱 유닛인 '타일(tile)'들은 각각 자신만의 작은 로컬 메모리를 보유하고 있습니다. 이번 성능 비교 테스트에는 4개의 타일과 4개의 L3 노드로 구성된 클러스터가 사용되었지만, Frostbite의 전체 레이아웃은 총 16개의 타일로 설계되었습니다. 설계 과정에서 초기 합성(synthesis) 단계에서는 800 MHz의 클록 속도에 도달하기도 했으나, 최종 레이아웃 단계에서는 500 MHz로 조정되었습니다. 그럼에도 불구하고, Frostbite 클러스터는 비교 대상 코어 대비 면적당 성능(performance per area)에서 평균 8.77배라는 놀라운 수치를 기록했습니다. 아래의 데이터는 워크로드에 따라 전력 대비 성능이 어떻게 변화하는지를 명확하게 보여주며, Frostbite가 가진 압도적인 효율성을 입증하고 있습니다.
2부: 인터랙션 넷 기반의 혁신적 병렬 처리와 '무료 멀티스레딩' 메커니즘#
안녕하세요, AI 기술의 심연을 탐구하는 전문기자 딥러너(DeepLearner)입니다. 지난 1부에서 Frostbite CPU가 보여준 압도적인 전력 효율성에 대해 다루었다면, 이번 2부에서는 이 경이로운 칩이 어떻게 '무(無)'의 상태에서 AI 에이tem에 의해 설계될 수 있었는지, 그 혁신적인 설계 프로세스와 내부 메커니즘을 심층적으로 분석해 보겠습니다.
Architect Labs의 설계 팀은 매우 흥미로운 접근 방식을 취했습니다. 이들은 Frostbite를 설계할 때 소위 “zero architectural priors(설계에 대한 사전 지식 없음)” 상태에서 시작했다고 밝혔습니다. 이는 기존의 설계 관습이나 고정관념에 얽매이지 않겠다는 의지입니다. 우선 팀은 칩이 반드시 수행해야 할 워크로드를 선정했고, 이후 AI 에이전트들이 관련 논문과 벤치마크를 학습하며 스스로 Python 모델을 구축하고 핵심 컨셉을 선택하는 과정을 거쳤습니다. 초기 단계에서 생성된 141페이지 분량의 PDF 출력물에는 프로그래밍 모델, 런타임, 그리고 하이레벨 블록에 대한 상세 정보가 담겨 있었습니다. 하지만 놀랍게도 이 문서는 첫 번째 RTL(Register-Transfer Level) 설계가 생성된 직후 삭제되었습니다. 그 이유는 "많은 수치와 추정치가 물리적으로 가능한 범위를 크게 벗어나 있었기 때문"이라고 팀은 솔직하게 밝혔습니다.
이러한 시행착오를 거치며 AI 에이런트들은 더욱 정교한 설계 언어를 채택했습니다. 영어 기반의 설계는 세부 사항을 놓치거나 오류를 잡아내는 데 한계가 있었기 때문입니다. 설계 프로세스의 핵심적인 기술적 요소들을 정리하면 다음과 같습니다.
- ASL (Architect Labs' Specification Language): 에이전트들이 영어 대신 사용한 독자적인 설계 언어입니다. 이 언어는 Lean(증명 검사기)으로 변환될 수 있어, 설계 내용이 수학적으로 정확한지 기계적으로 검증(machine-checked)할 수 있습니다. 이는 대규모 버그를 방지하고, 에이전트들이 단순히 보상 수치만을 높이기 위해 설계 목적을 왜곡(gaming their objectives)하는 것을 차단합니다.
- Arcmodel: 실제 회로 설계가 존재하기 전, ASL을 기반으로 구축된 칩 전체의 소프트웨어 모델입니다. 칩의 논리적 구조를 미리 시뮬레이션할 수 있는 핵심 기반이 됩니다.
- 고속 시뮬레이션 루프: 실제 RTL 시뮬레이션은 속도가 매우 느리기다는 단점이 있습니다. 이를 극복하기 위해 에이전트들은 Arcmodel을 활용했는데, 이는 RTL 시뮬레이션보다 약 200배 더 빠른 속도로 구동되었습니다.
- 자동화된 오차 조정 시스템: 초기 Arcmodel의 전력 추정치는 실제 회로 설계와 비교했을 때 최대 약 250%까지 차이가 날 정도로 부정확했습니다. 그러나 에이전트들은 자동화된 루프를 통해 이 오차를 수정해 나갔고, 결국 실제 회로 설계와 5% 이내의 오차 범위 안으로 일치시키는 데 성공했습니다.
- 에이전트 스웜(Swarms)의 병렬 제안: 수많은 에이전트들이 병렬적으로 설계 변경안을 제안했습니다. 각 제안은 설계 사양(spec) 검증, 빠른 모델 테스트, RTL 설계 반영, 그리고 전력 측정이라는 엄격한 필터링 과정을 거쳤습니다. 이 과정을 통해 총 58개의 아이디어가 시도되었고, 그중 최종적으로 37개의 아이디어가 채택되었습니다.
이 설계 과정에서 가장 놀라운 점은 인간이 단 한 번도 명시하거나 명령하지 않았음에도 불구하고, 시스템 내부에서 스스로 발현된 “인간이 지정하지 않은 행동(behavior)”이 발견되었다는 점입니다. 바로 'work stealing(작업 탈취)' 메커니즘입니다. 이는 일감이 없는 특정 타일(tile)이 인접한 다른 타일로부터 남는 작업을 가져오거나, 수행할 작업이 없을 경우 스스로 idle(유휴) 상태로 전환하여 전력을 아끼는 지능적인 동작입니다.
결국 Frostbite의 탄생은 단순히 AI가 도구로 사용된 것을 넘어, AI 에이전트들이 설계의 주체가 되어 스스로 오류를 수정하고, 최적의 효율을 찾아가는 자율적인 진화 과정을 보여준 사례라고 할 수 있습니다. 인간의 설계 관습을 배제한 '백지 상태'에서의 도전이, 어떻게 전력 효율 4.59배라는 압도적인 결과물로 이어졌는지 우리는 주목해야 합니다.
3부: 7nm 시뮬레이션 성능 지표와 AI의 자율적 설계 프로세스#
이번 Frostbite 설계의 핵심은 단순히 성능을 높이는 것을 넘어, 칩 내부의 에너지가 어디에 어떻게 소비되는지를 정밀하게 제어하는 데 있습니다. 시뮬레이션 데이터를 살펴보면, 명령어의 페칭(Fetching), 디코딩(Decoding), 그리고 발행(Issuing) 단계부터 온칩 네트워크(On-chip network)와 스케줄러(Scheduler)의 작동에 이르기까지 에너지가 분산됩니다. 특히 주목할 점은 클록 분배(Clock distribution) 영역입니다. 앞서 언급된 주요 에너지 소비 항목들 외에도 클록 분배가 전체 에너지에서 차지하는 비중은 매우 중요한 변수로 작용하며, 설계 과정에서 이 부분의 효율성을 극대화하는 것이 이번 프로젝트의 핵심 과제 중 하나였습니다.
Architect Labs의 이러한 혁신적인 행보는 이번이 처음이 아닙니다. 이들은 이미 지난 8월, 로봇과 드론을 위한 AI 추론 가속기인 'Redwood'를 선보이며 AI 설계의 가능성을 증명한 바 있습니다. 당시 놀라웠던 점은 단 두 명의 인간 아키텍트가 작성한 사양서(Spec)를 바탕으로, AI가 단 2주 만에 RTL(Register Transfer Level), 검증(Verification), 펌웨어(Firmware), 드라이버(Drivers), 그리고 커널(Kernels)에 이르는 전체 설계 스택을 생성해냈다는 사실입니다. 현재 Redwood는 아직 FPGA 상에서만 구동되고 있으며 실제 실리콘(Silicon)으로 제작되지는 않은 상태이지만, Architect Labs는 이를 TSMC의 공정을 통해 양산하는 것을 목표로 매진하고 있습니다.
물론 시장의 경쟁도 뜨겁습니다. 영국 캠브리지(Cambridge, U.K.)에 본사를 둔 잠재적 경쟁자인 'Tendrils Compute'는 바로 이번 달 초, "수천 개의 코어가 병렬로 작동하는" 프로세서를 개발 중이라며 대규모 투자 유치에 성공했습니다. 흥히 흥미로운 점은 Tendrils Compute 역시 Frostbite의 프로그램이 작성되는 것과 동일한 언어인 'Vine'을 개발하고 있다는 사실입니다. 이는 차세대 AI 가속기 시장의 주도권을 잡기 위한 언어 생태계와 하드웨어 설계 기술이 이미 치열한 각축장에 들어섰음을 시사합니다.
Architect Labs는 여기서 멈추지 않고 더 방대한 벤치마크 데이터를 공개할 예정입니다. 이들의 계획은 단순한 성능 지표 제시를 넘어, 누구나 Frostbite에서 프로그램을 실행해 볼 수 있는 FPGA 기반의 '소프트웨어 플레이그라운드(Software playground)'를 구축하는 것입니다. 이와 함께 '예비 운영체제(Preliminary operating system)'를 선보임으로써 개발자 생태계를 구축할 계획이며, 궁극적으로는 Frostbite의 RTL과 명령어 세트(Instruction set)를 공개하여 개방형 생태계를 완성하겠다는 포부를 가지고 있습니다.
향후 로드맵 또한 매우 구체적입니다. Architect Labs는 더 넓은 범위의 워크로드를 커버하기 위해, 대형 캐시를 탑한 멀티코어 버전의 비교 코어와 더 큰 규모의 'Frostbite 메쉬(Mesh) 구성'을 대조하는 등 더 광범위한 CPU 세트와의 비교를 준비 중입니다. 또한, 향후 몇 달 내에 SPEC 및 PARSEC과 같은 대중적인 CPU 벤치마크 스위트를 활용하여, 더 크고, 더 넓으며, 비순차적 실행(Out-of-order)이 가능한 CPU들과의 성능 대결을 펼칠 예정입니다. 이는 AI가 설계한 칩이 기존의 고성능 컴퓨팅 구조를 얼마나 압도할 수 있을지를 보여주는 결정적인 시험대가 될 것입니다.
한눈에 보는 핵심 비교 분석#
| 비교 항목 | 기존 방식 (Traditional) | 신규 기술 (Frostbite/Redwood) | 핵심 차이점 |
|---|---|---|---|
| 설계 프로세스 | 인간 아키텍트의 수동 설계 및 검증 | AI 에이전트 기반 자율 설계 (RTL~Kernel) | 설계 기간을 2주 미만으로 단축 |
| 개발 범위 | 하드웨어와 소프트웨어 스택의 분리 개발 | AI가 펌웨어, 드라이버, 커널까지 일괄 생성 | 설계 사양(Spec)에서 즉각적인 스택 생성 가능 |
| 언어 및 생태계 | C/C++ 등 범용 언어 중심 | Vine 언어 기반의 전용 생태계 구축 | 하드웨어 최적화된 전용 언어 활용 |
| 확장성 전략 | 정해진 코어 수 기반의 구조 | 대규모 메쉬(Mesh) 및 대형 캐시 구성 | AI를 통한 유연한 아키텍처 확장성 확보 |
독자 체크리스트 및 자주 묻는 질문 (FAQ)#
💡 차세대 AI 칩 시장 관전 포인트 체크리스트
- [ ] 설계 자동화 수준: AI가 RTL부터 커널까지 전체 스택을 생성할 수 있는가?
- [ ] 에너지 효율성: 클록 분배 및 온칩 네트워크의 에너지 점유율이 최적화되었는가?
- [ ] 생태계 확장성: Vine과 같은 전용 언어와 소프트웨어 플레이그라운드가 구축되었는가?
- [ ] 공정 로드맵: FPGA 단계를 넘어 TSMC와 같은 파운드리 실리콘 공정으로 이어지는가?
❓ 자주 묻는 질문 (FAQ)
Q1. Architect Labs의 Redwood는 현재 바로 사용할 수 있는 제품인가요? A1. 아니요, Redwood는 현재 FPGA(Field Programmable Gate Array) 상에서만 구동되는 상태입니다. 하지만 Architect Labs는 이를 실제 실리콘 칩으로 구현하기 위해 TSMC 공정을 활용하는 방안을 추진하고 있습니다.
Q2. 향후 Frostbite의 성능을 어떻게 검증할 계획인가요? A2. Architect Labs는 향후 몇 달 안에 SPEC 및 PARSEC과 같은 업계 표준 벤치마크 스위트를 사용하여, 기존의 더 크고 넓은 구조를 가진 비순차적 실행(Out-of-order) CPU들과의 직접적인 성능 비교 데이터를 공개할 예정입니다.
딥러너 (DeepLearner)이었습니다.
🔗 원문 참고 및 출처: AI agents design an entirely new CPU architecture from scratch, startup claims


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성